SQL Join 重排为什么可能失效?
面试怎么回答
Join 重排是在结果语义不变的前提下,比较不同连接树的成本。普通内连接重排自由度较高,外连接、相关子查询和未展开的视图会形成边界;统计信息失真会让成本判断出错,表太多又会受到搜索空间和规划时间限制。排查时我会对比 EXPLAIN ANALYZE 的估算与实际行数,找到第一个偏差节点,优先修统计、过滤和中间结果,再把 Hint 当作验证或有监控的兜底。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一条六表关联 SQL,开发按“先小表、后大表”认真排好了顺序,执行计划却完全不是这个顺序。把 JOIN 再换一遍,耗时仍然没变化。
这不是优化器没看懂 SQL,而是内连接、外连接、统计信息和搜索空间共同决定了 Join 能不能重排、会怎么重排。
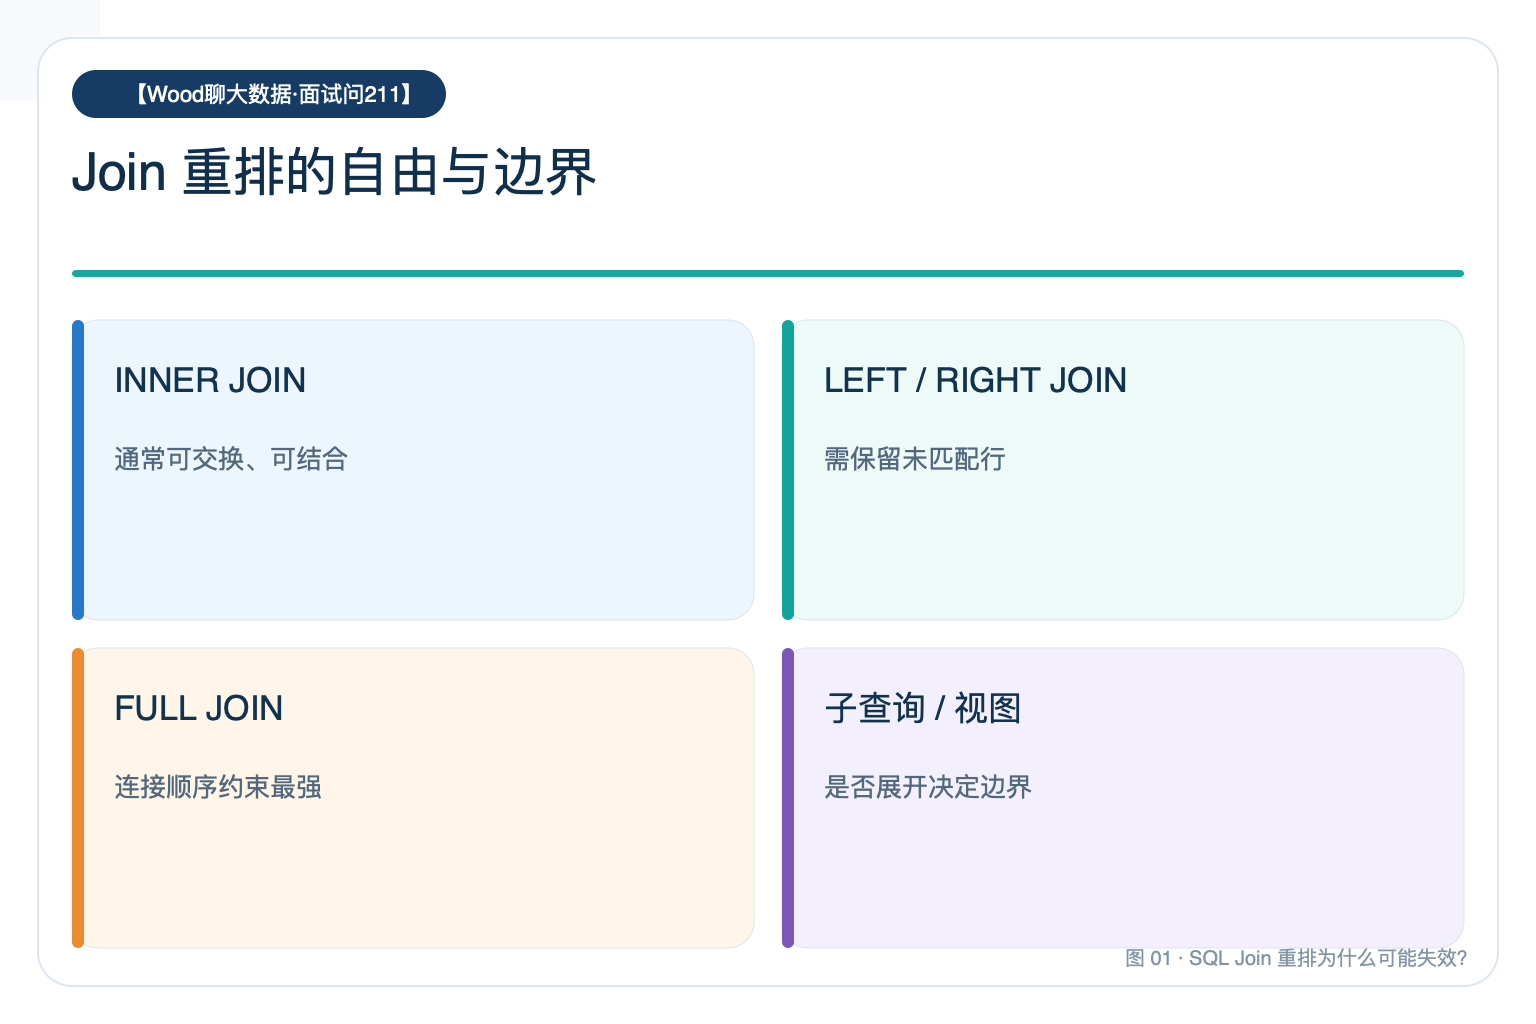
Join 重排是在语义等价的前提下搜索更低成本的连接树;外连接边界、子查询未展开、统计信息失真和搜索空间过大,都可能限制或误导重排。
先区分逻辑顺序和物理顺序
普通 INNER JOIN 满足结合律和交换律,优化器通常可以先连接过滤后更小的表,再连接大表。SQL 中书写顺序主要表达逻辑关系,不等于物理执行顺序。真正要看的是 EXPLAIN 中的连接树、每个节点估算行数和实际行数。
外连接会形成语义边界
LEFT JOIN 必须保留左表未匹配行,FULL JOIN 的约束更强,因此不能像纯内连接一样任意交换。过滤条件放在 ON 还是 WHERE 还可能改变是否保留空值扩展行。优化器只能在能够证明语义等价的范围内移动节点。
统计信息决定成本判断
重排不是简单地把小表放前面,而是比较扫描、过滤、Join 算法和中间结果成本。如果基数、NDV、空值率或字段相关性估错,优化器可能认为某一步只返回一万行,实际却产生一亿行,于是选择了错误的连接树。
搜索空间不会无限展开
N 张表的候选连接顺序会快速膨胀。数据库通常设置 join_collapse_limit、GEQO 阈值或启发式规则,在规划时间和计划质量之间取舍。表越多,并不代表优化器一定穷举出全局最优解。
排查要对比估算与实际
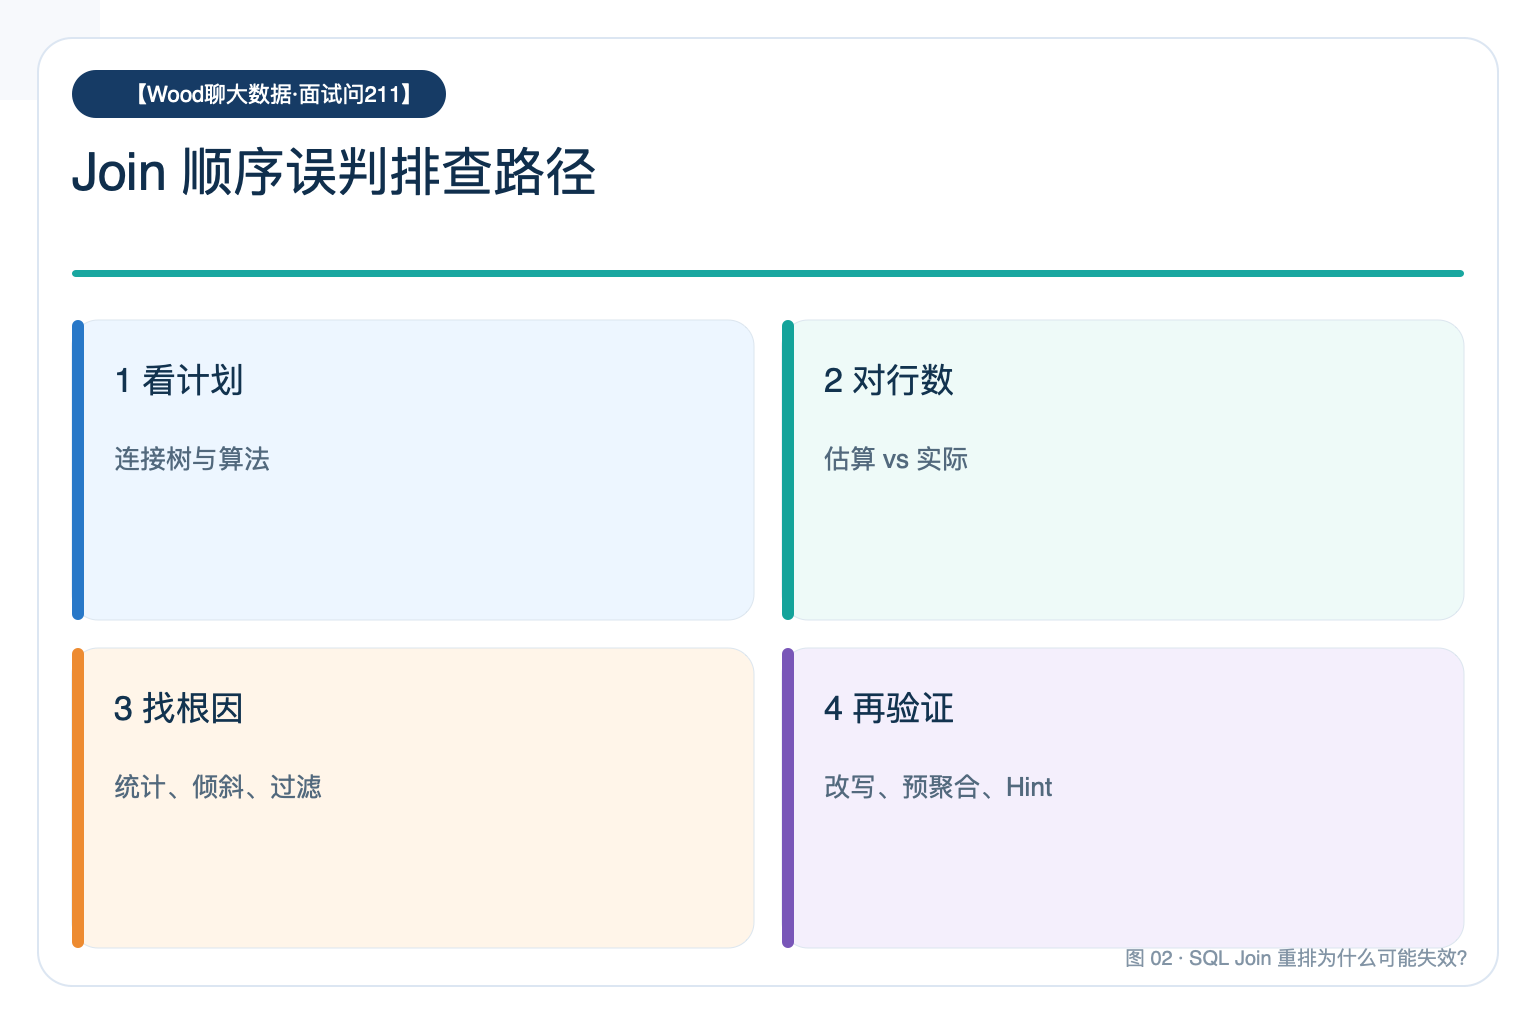
我会先执行 EXPLAIN ANALYZE,找第一个 estimated rows 与 actual rows 明显偏离的节点,再检查过滤下推、统计信息和数据倾斜。随后尝试补统计、拆分复杂 SQL、预聚合或建立优化边界,而不是先靠强制 Join 顺序长期兜底。
Hint 只能作为受控手段
显式 Join 顺序或 Hint 可以快速验证“换顺序是否有效”,但数据分布变化后容易失效。生产上要记录适用条件、计划基线和回归指标;如果根因是统计信息过期,只锁计划会把问题推迟到下一次数据增长。
参考资料
- PostgreSQL:Controlling the Planner with Explicit JOIN Clauses:https://www.postgresql.org/docs/current/explicit-joins.html