SQL UNION 和 UNION ALL 有什么区别?
面试怎么回答
UNION 会对合并后的整行结果去重,通常需要额外的排序或聚合,成本高于只做拼接的 UNION ALL;UNION ALL 会保留所有重复行。追加互斥数据集时我优先用 UNION ALL;如果要按业务主键保留一条,会先 UNION ALL,再用 ROW_NUMBER 按明确规则去重。同时要显式对齐列顺序、类型,并在最外层统一排序。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
先说结论:UNION 会对合并后的整行结果去重,UNION ALL 会原样保留所有行。
看起来只差一个 ALL,却经常同时影响结果行数、执行成本和数据语义。
真正要回答的不是“哪个更快”,而是:业务到底要拼接全集,还是要消除完全相同的结果行?
先看一个最小例子
表 A:
1, A
2, B
表 B:
2, B
3, C
使用 UNION ALL,两张表的 4 行都会保留;使用 UNION,完全相同的 (2, B) 只保留一行,结果是 3 行。
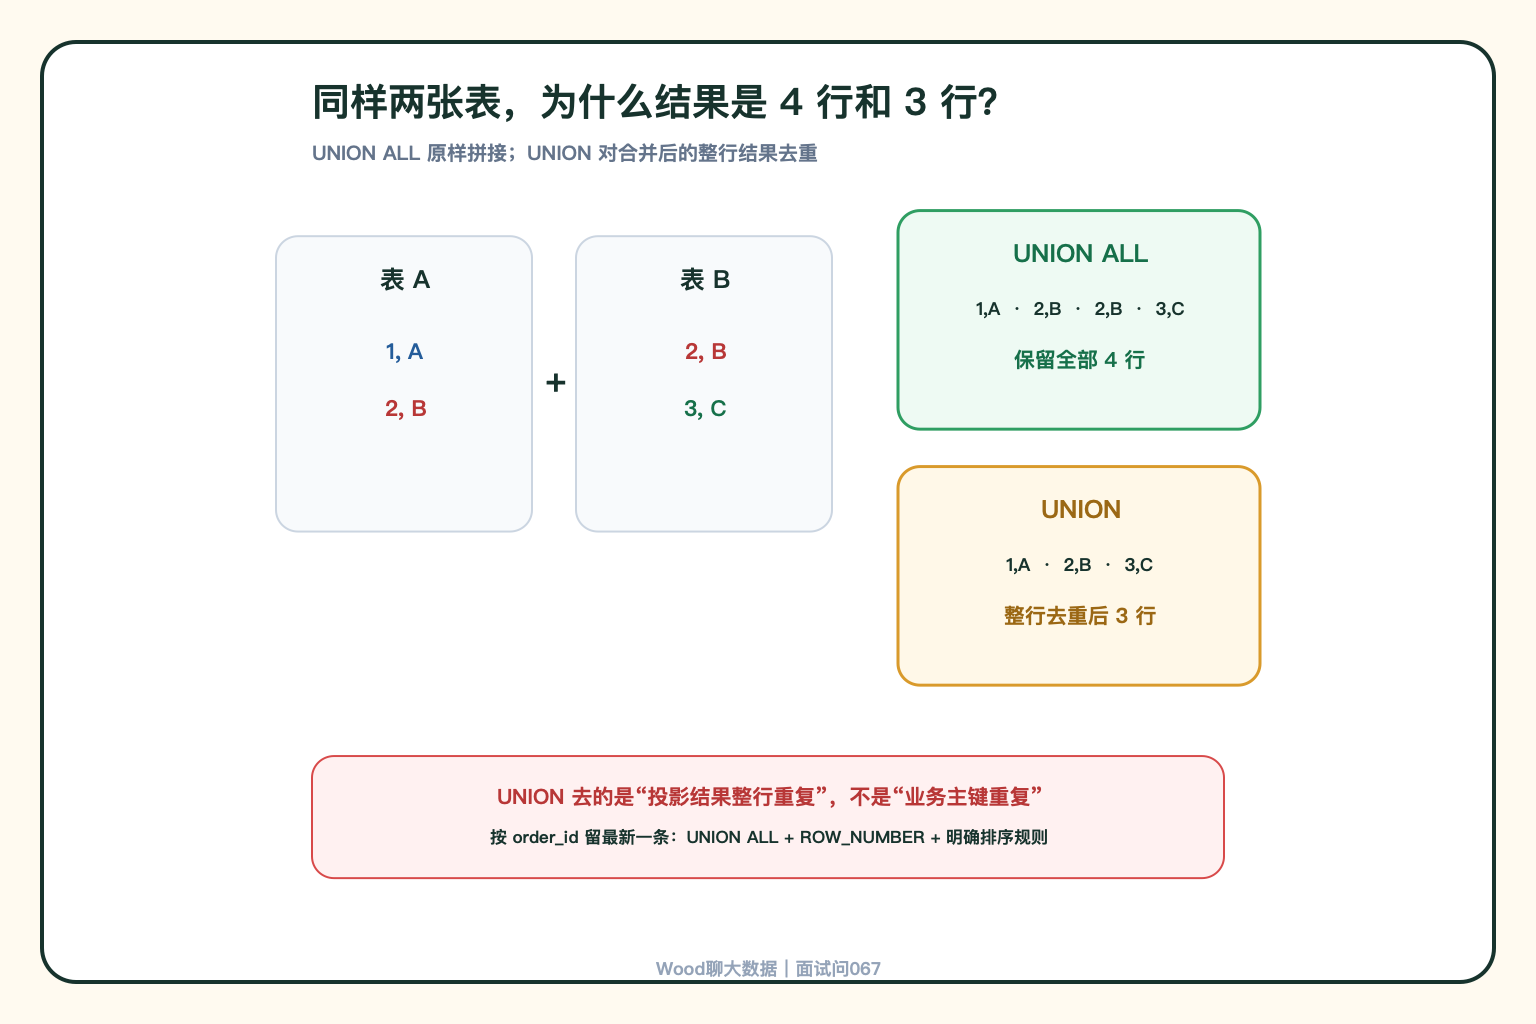
UNION:合并后做集合去重
UNION 判断的是投影结果的整行是否重复,不是只看某一个业务主键。
SELECT order_id, user_id, amount FROM order_a
UNION
SELECT order_id, user_id, amount FROM order_b;
如果两行 order_id 相同,但 amount 不同,它们仍然会同时保留。也就是说,UNION 不能替代“按业务主键保留最新一条”的去重逻辑。
执行时,为了消除重复行,数据库或计算引擎通常需要增加 Hash Aggregate、Sort 或类似的去重阶段,因此往往比 UNION ALL 成本更高,但具体计划仍要以实际引擎为准。
UNION ALL:只拼接,不去重
UNION ALL 不额外消除重复,通常更适合:
- 合并互斥日期或互斥分区
- 汇总多张结构相同的来源表
- 保留真实重复记录供后续判断
- 已经能证明各分支不会重叠的场景
当业务只是把多个数据集追加到一起,优先使用 UNION ALL,不要为了“看起来安全”而无条件使用 UNION。
真正按业务主键去重怎么做?
如果两张表可能包含同一个订单的不同版本,需求是保留更新时间最新的一条,更清楚的写法是:
SELECT order_id, user_id, amount
FROM (
  SELECT
    t.*,
    ROW_NUMBER() OVER (
      PARTITION BY order_id
      ORDER BY update_time DESC, source_priority DESC
    ) AS rn
  FROM (
    SELECT * FROM order_a
    UNION ALL
    SELECT * FROM order_b
  ) t
) s
WHERE rn = 1;
先用 UNION ALL 保留候选记录,再用明确的业务键和排序规则选择一条,语义比全行去重更准确。
三个容易忽略的坑
列按位置对应,不按字段名自动匹配
各分支必须返回相同数量、顺序兼容且类型可转换的列。生产 SQL 最好显式写字段和类型,不要依赖 SELECT *,否则表结构变化可能让列错位或任务失败。
UNION 不保证输出顺序
如果最终结果需要排序,应在整个集合查询外层使用 ORDER BY,不能依赖各分支原有顺序。
去重可能掩盖上游问题
如果重复本来来自任务重跑、Join 放大或数据同步异常,用 UNION 抹掉结果,只是隐藏了问题。先确认重复产生原因,再决定是否需要去重。