SQL 分区裁剪为什么会失效?
面试怎么回答
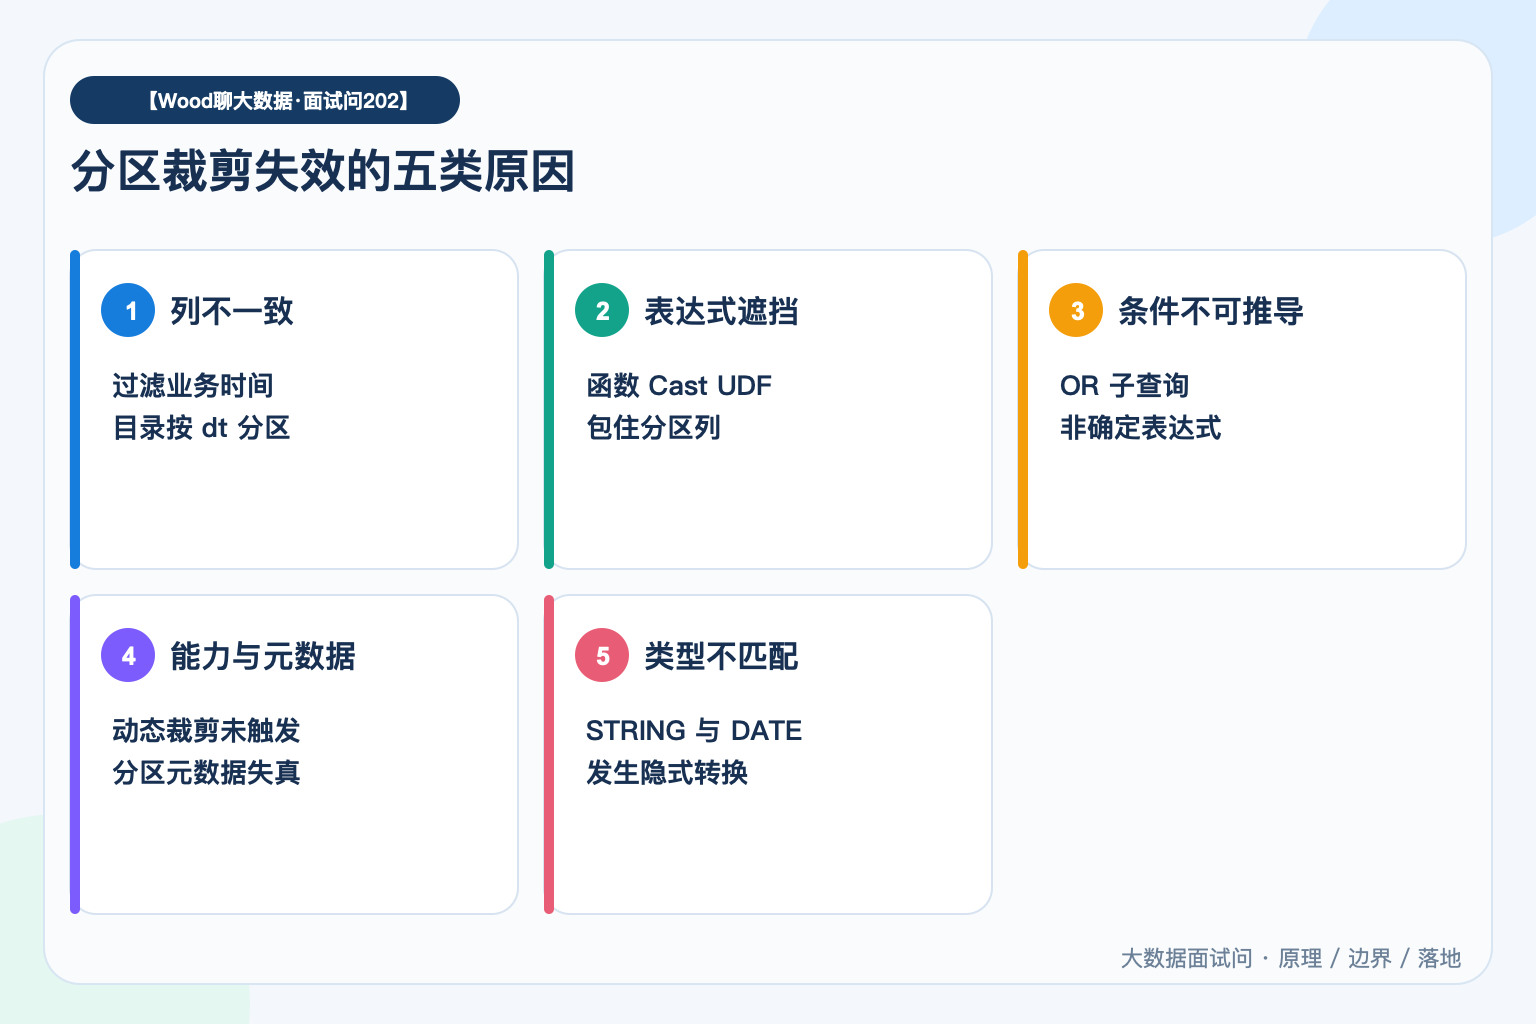
我会先确认过滤字段是否真的是物理分区列,再看条件能否被优化器静态推导。常见失效点包括对分区列包函数、隐式类型转换、OR 和 UDF、动态子查询条件,以及分区元数据与目录不一致。排查时看执行计划中的 PartitionFilters、实际扫描分区和文件数,再把条件简化后逐层加回。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
WHERE 里明明写了日期条件,执行计划却扫描了整张分区表。
分区裁剪不是“出现日期字段就生效”,优化器必须能把条件解析成对分区列的确定约束,并且分区元数据、类型和表达式都能对上。
分区裁剪失效通常来自过滤列不对、函数包裹、类型转换、条件不可静态推导或元数据不一致;先看扫描分区,再按表达式逐层排查。
先确认过滤的是物理分区列
业务日期 event_date、事件时间 event_time 和目录分区 dt 可能不是同一列。只过滤 event_time,并不保证优化器能推导 dt 范围。最稳妥的查询通常同时写业务精确条件和与之对应的分区条件。
函数和隐式转换会遮住分区列
对分区列做 date_format、substr、cast 或计算,可能让优化器无法直接匹配分区值。相比 WHERE to_date(ts)=date,优先改成原列的闭开区间;字符串分区与 DATE 参数比较时,也要避免不可预期的隐式转换。
动态条件要看引擎支持
分区值来自子查询、变量、Join 另一侧时,编译期可能无法确定。部分引擎支持动态分区裁剪或运行时过滤,但需要满足 Join 形态、统计信息和数据源能力。不能把静态裁剪没发生,简单归因于“优化器太差”。
OR、非确定函数和复杂表达式最容易出问题
跨分区列与非分区列的 OR 条件、当前时间函数、UDF 或难以化简的 CASE,会让裁剪范围扩大。先把条件拆成可证明的范围,必要时用 UNION ALL 分开不同分支,再观察每个分支扫描哪些分区。
元数据与文件布局也要一致
Metastore 中没有及时新增分区、目录格式和分区值不一致、表定义变更后缓存未刷新,都可能让计划与实际文件对不上。湖仓表还要区分隐藏分区转换和用户看到的源列,按表格式的谓词转换规则判断。
排查不要只看 SQL 文本
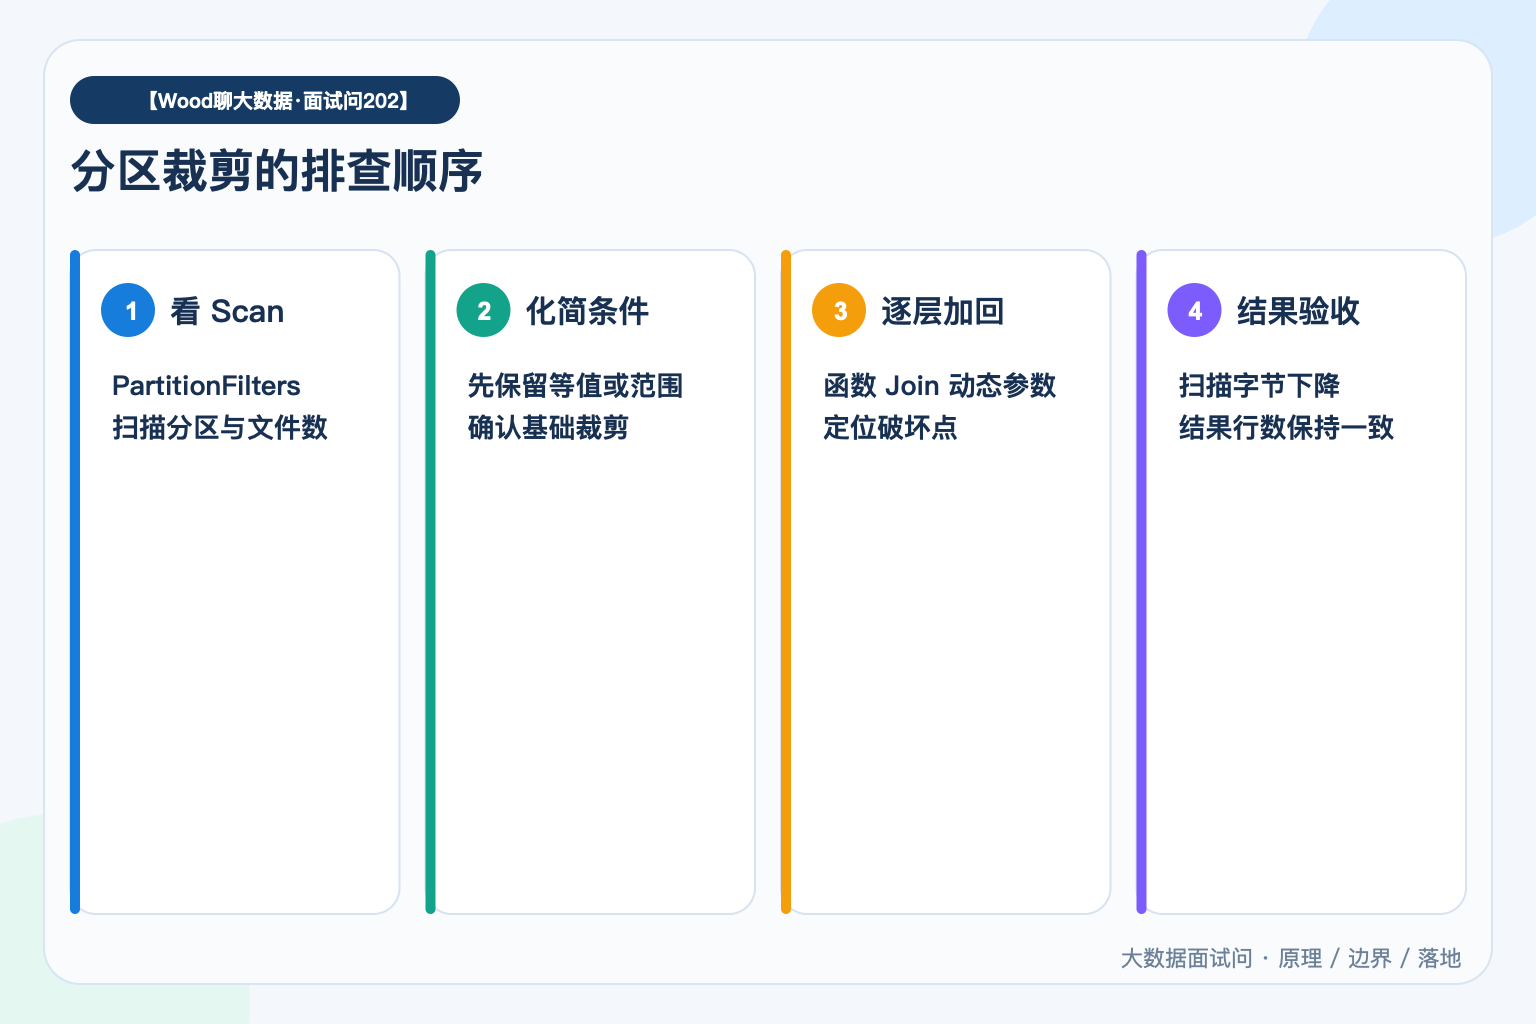
第一步从 EXPLAIN、SQL UI 或 Scan 节点确认 PartitionFilters 和实际文件数;第二步把条件简化到分区列等值或范围;第三步逐个加回函数、Join 与动态参数。最后用扫描字节和分区数验收,而不是只看任务跑快了几秒。
参考资料
- Spark SQL Performance Tuning:https://spark.apache.org/docs/latest/sql-performance-tuning.html
- Spark Parquet Data Source:https://spark.apache.org/docs/latest/sql-data-sources-parquet.html