覆盖索引和 Index Only Scan 怎么理解?
面试怎么回答
覆盖索引是设计层概念,表示查询所需列都存放在索引里;Index Only Scan 是实际执行方式。字段覆盖只是前提,还要看索引类型、MVCC 可见性和成本估算。优化时我会用 EXPLAIN ANALYZE 关注 Heap Fetches 和 Buffers,并权衡索引宽度、写放大与缓存占用,不会为了覆盖查询把整行都放进索引。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
查询明明命中了索引,执行计划里却还有大量回表,延迟并没有降下来。
“用了索引”和“只读索引就能完成查询”,是两个完全不同的层次。
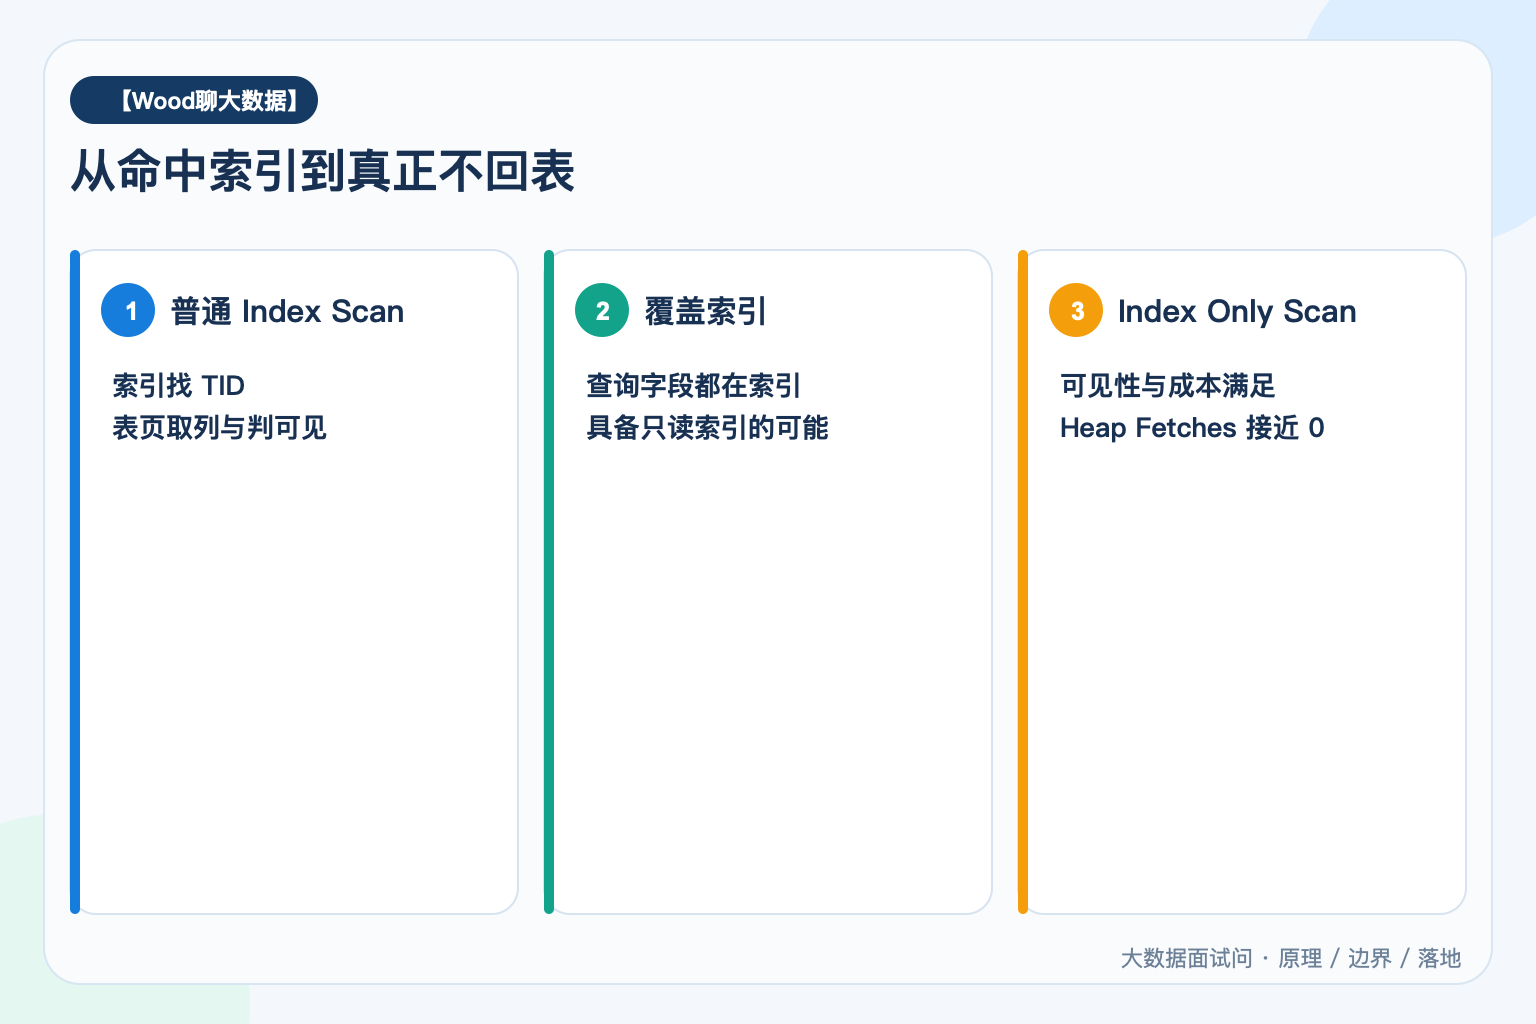
覆盖索引描述的是查询所需字段都在索引中;Index Only Scan 是优化器在可见性和成本满足条件时,真正只从索引返回结果的执行方式。
普通索引扫描为什么还要回表
二级索引保存索引键以及定位表记录的信息。WHERE 条件可以通过索引快速找到候选记录,但 SELECT 列表里缺少的字段仍要从表页读取;MVCC 数据库还可能需要回表判断记录对当前事务是否可见。随机回表很多时,索引命中不一定代表整体 I/O 小。
覆盖索引解决的是字段是否齐全
如果过滤、连接、排序和返回所需的列都能从同一个索引获得,这个索引就覆盖了该查询。PostgreSQL 可以用 INCLUDE 保存仅用于返回的负载列,让它不参与索引排序和唯一性判断;MySQL 的联合索引也可能直接覆盖查询。
Index Only Scan 还需要执行条件成立
以 PostgreSQL 为例,即使字段已覆盖,也要通过 Visibility Map 判断对应堆页是否 all-visible;频繁更新的热表可见性位不足,仍会出现 Heap Fetches。优化器还会比较全表扫描、普通索引扫描和 Index Only Scan 的成本,不会机械选择索引。
不要把所有字段都塞进索引
索引越宽,占用的磁盘与缓存越多,写入、更新和维护成本越高,过宽字段还可能触及索引元组大小限制。覆盖索引应该围绕真实高频查询设计:选择性强的列做键,少量稳定返回列做 INCLUDE,并避免重复建设高度相似的索引。
如何验证是否真的减少回表
用 EXPLAIN ANALYZE 查看节点类型、实际行数、Buffers 和 Heap Fetches。若是 Index Only Scan 但 Heap Fetches 仍高,需要检查表更新频率、VACUUM/可见性维护和查询范围;若优化器选择 Seq Scan,则可能是返回比例太高或统计信息失真。
典型判断
一张订单历史表按 tenant_id、created_at 查询,并返回 order_id、amount。可以把前两列作为索引键,把常用返回列作为 INCLUDE。它适合读多写少、查询形态稳定的历史数据;如果 amount 高频更新,额外索引维护成本可能超过节省的回表。
参考资料
- PostgreSQL Index-Only Scans:https://www.postgresql.org/docs/current/indexes-index-only-scans.html