SQL 如何计算中位数和分位数?
面试怎么回答
中位数是 P50。我会先确认业务要连续分位数还是离散分位数:前者可能插值,后者返回实际观测值。小规模或审计场景使用精确函数,也可以通过分组排序和行号计算;大规模监控可以使用近似分位数降低排序成本,但要说明精度和误差。最后统一 NULL、数据类型和分组口径,并用边界样本验证偶数行、重复值和极端值。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一批任务的平均耗时只有 3 秒,但用户仍然频繁投诉“偶尔特别慢”。
这时平均值可能掩盖长尾,真正该看的往往是 P50、P95、P99。
中位数就是 P50,但计算前要先区分连续分位数、离散分位数和近似分位数,它们的语义与成本并不相同。
先明确要哪一种分位数
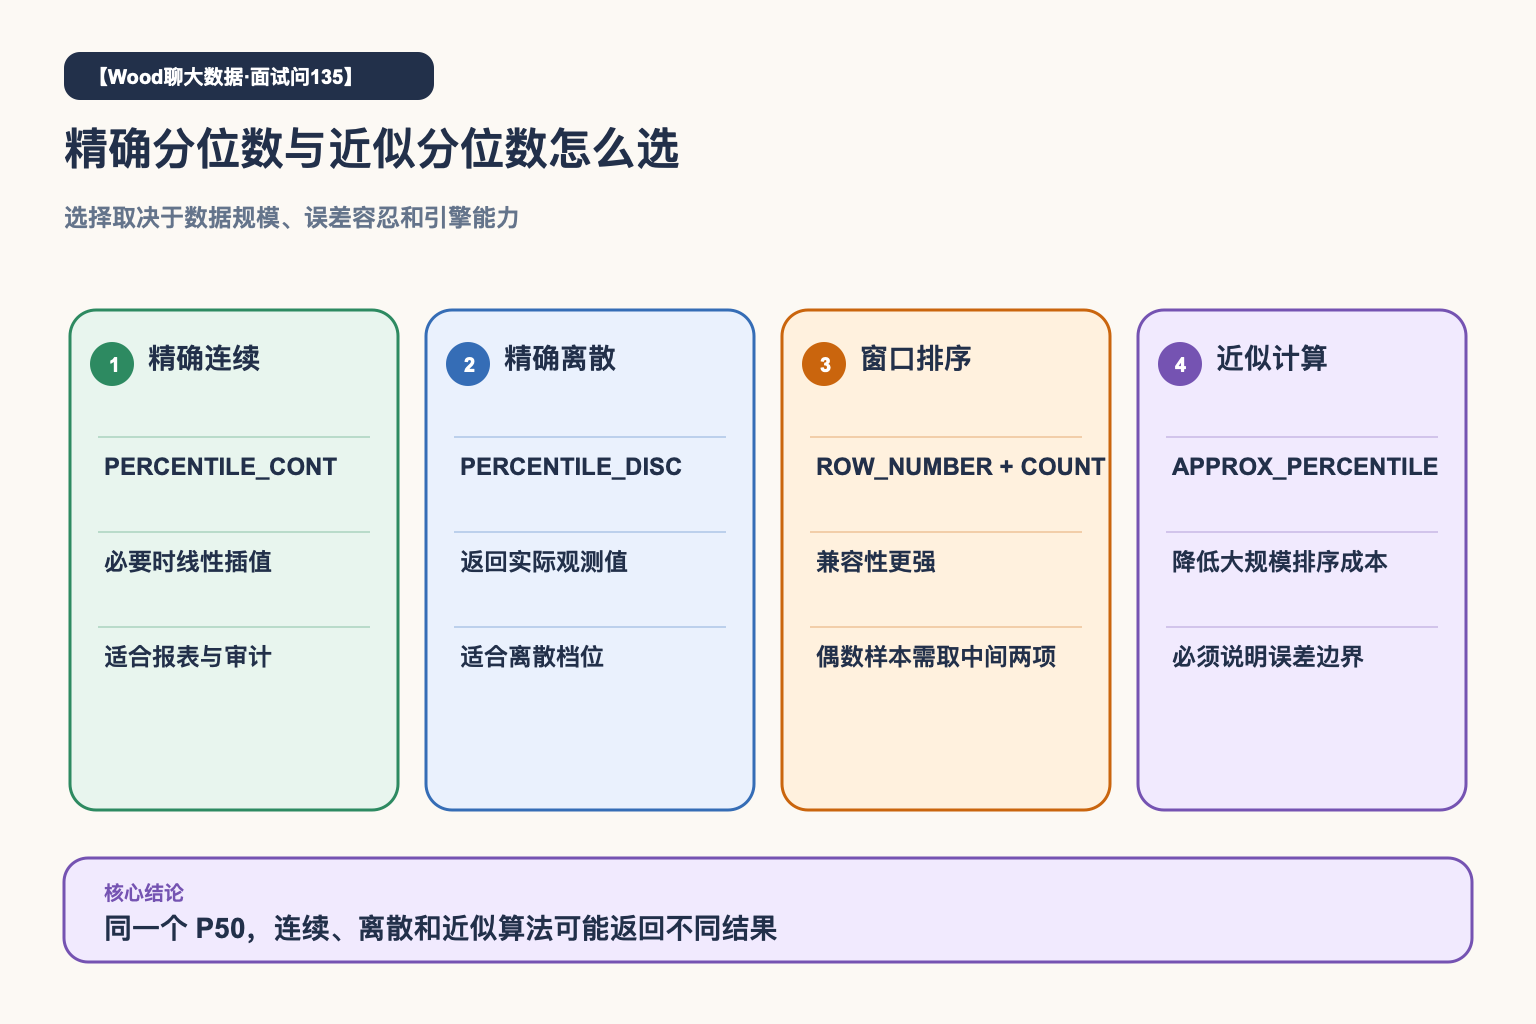
连续分位数通常允许在相邻观测值之间插值,例如 PERCENTILE_CONT;离散分位数从真实观测值中选择一个,例如 PERCENTILE_DISC。
当样本数为偶数时,两者尤其可能不同。面试中只说“排序后取中间值”还不够,还应说明两项取平均还是返回某个实际值。
精确计算通常意味着排序
数据库提供分位数函数时应优先使用,语义更清晰。如果引擎没有对应函数,也可以使用 ROW_NUMBER 和 COUNT:先在分组内排序,计算总行数,再取中间位置;偶数样本取中间两项平均即可得到常见中位数。
这种方案容易理解,但大数据量下全局或分组排序成本很高,数据倾斜时某些分组还可能成为单点瓶颈。
大规模场景考虑近似算法
很多大数据引擎提供 APPROX_PERCENTILE、percentile_approx 等近似函数,用摘要结构换取更低的内存和排序成本。
近似不等于随便算。要说明误差或精度参数、相同输入是否稳定、是否支持合并,以及该指标能不能用于财务结算或审计。实时监控通常更能接受近似,强审计报表更倾向精确。
NULL、分组和数据类型也会改变结果
多数分位数函数会忽略 NULL,但不能默认所有引擎都一致。金额字段如果用浮点类型,还可能引入精度问题。
按渠道、地区计算 P99 时,必须在每个分组内部独立排序或生成摘要。不能先算全局 P99,再按维度拆分。
一个典型场景
某监控报表从精确 P99 切换到近似 P99 后,曲线出现轻微跳动。任务本身没有变慢,原因是新函数采用了近似摘要,且精度参数过低。
团队如果只对比单个结果,会误判为性能回退。更合理的验证是用多天数据对比误差分布,同时核对 P50、P95、P99 和最大值,再决定是否满足监控场景。
分位数计算的第一问是语义,第二问才是函数。