SQL 如何计算次日、7日和30日留存率?
面试怎么回答
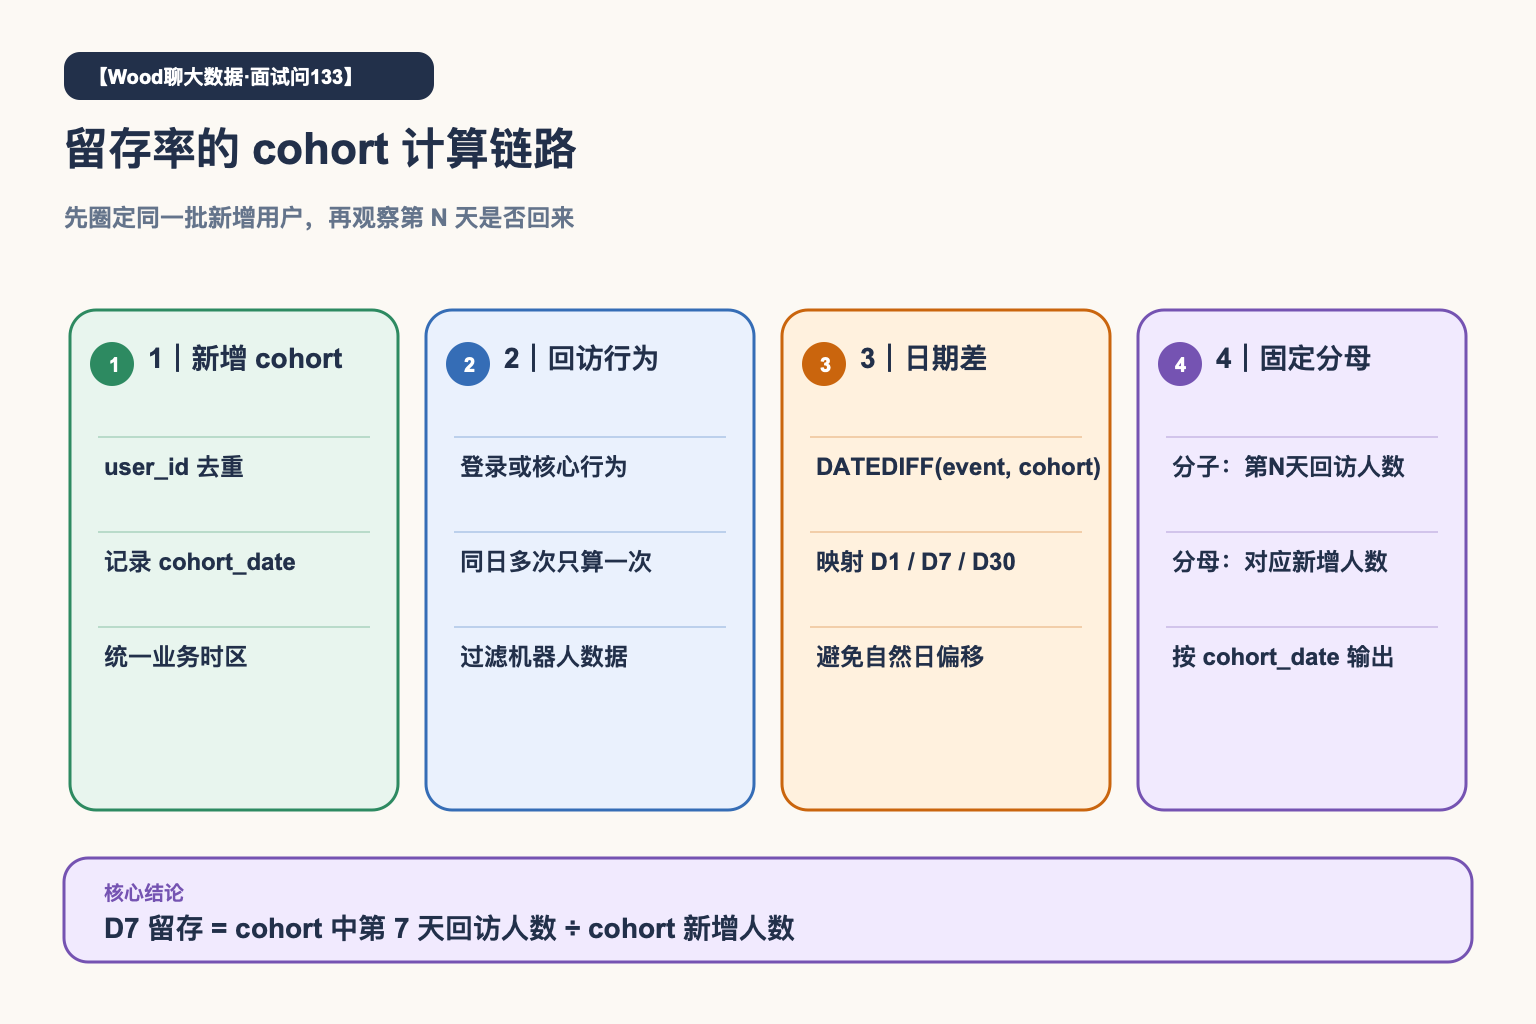
我会先定义新增用户 cohort 和业务时区,再把回访行为去重到用户日粒度。然后将行为日期与 cohort 日期做日期差,分别统计 D1、D7、D30 的去重回访用户数,分母固定为对应 cohort 的新增人数。还要区分“第 N 天”和“N 天内”,对尚未成熟的日期保留 NULL,并用人数、比率和用户样本三层校验,防止 Join 放大分母。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
产品说“看一下最近一周的次日、7日和30日留存”,很多人马上就开始写 SQL。
可真正决定结果的,往往不是窗口函数,而是:新增用户是哪一批、什么行为算回来、日期差按哪个时区计算。
留存率的核心不是比较两个日期的 DAU,而是固定一批新增用户,观察同一批人在第 N 天是否再次出现。
第一步:先定义新增用户 cohort
cohort 可以理解为同一天进入系统的一批用户。最常见的是注册日期,也可能是首次付费日期、首次启动日期或第一次完成核心行为的日期。
建 cohort 时要先对 user_id 去重,并明确业务时区。一个用户重复注册、账号合并或跨时区上报,都可能让新增人数变大。
第二步:明确什么叫“回来”
回访行为不能默认等于任意日志。登录、启动 App、观看内容和完成支付,代表的是不同留存口径。
同一个用户在同一天触发多次行为,只能计为一个回访用户。因此通常先把行为表整理成 user_id + event_date 的日粒度集合,再与 cohort 关联。
第三步:用日期差映射 D1、D7、D30
把 event_date 与 cohort_date 做日期差:差值为 1 是次日留存,差值为 7 是 7 日留存,差值为 30 是 30 日留存。
这里最容易混淆“第7天留存”和“7天内留存”。前者只看第7个自然日,后者看一个区间,SQL 条件和业务含义完全不同。
COUNT(DISTINCT CASE WHEN day_diff = 7 THEN user_id END)
/
COUNT(DISTINCT user_id)
真正落地时,分子和分母最好分别聚合后再相除,避免行为明细 Join 后把 cohort 分母重复放大。
第四步:分母必须固定在对应 cohort
某天的 D7 留存分母,是七天前那批新增用户,不是某天 DAU,也不是七天内所有新增用户。
输出通常以 cohort_date 为行,以 D1、D7、D30 为列。越新的 cohort 还没有走到第30天,对应位置应该保持 NULL 或“未成熟”,不能当成 0,否则最近日期的留存曲线会被人为拉低。
一个典型场景
一张看板显示次日留存突然上涨,但新增用户数和产品版本都没有明显变化。继续核对才发现,SQL 用“次日活跃用户数 ÷ 当日新增用户数”,分子并没有限制为当日新增的那批人。
老用户越活跃,这个所谓的留存率就越高,甚至可能超过 100%。
修正方式不是换一个函数,而是先生成新增 cohort,再按 user_id 关联后续行为,并分别验证 cohort 人数、回访人数和抽样明细。
留存是一种 cohort 分析,用户身份必须贯穿分子和分母。