MySQL redo log、undo log 和 binlog 有什么区别?CDC 为什么读 binlog?
本文目录
面试怎么回答
redo 是 InnoDB 的恢复日志,undo 用于回滚和一致性读,binlog 是 Server 层传播变更及增量恢复的日志。常见 MySQL CDC 读 binlog,是因为它需要可定位的事务变更通道,而不是引擎内部数据页恢复记录。生产上还要核验格式、行镜像、权限和保留窗口;源库正常不代表旧位点仍能续读。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同样叫日志,redo、undo 和 binlog 经常被背成三个名词。可一旦问题变成“同步任务停了几天,数据库还在,为什么增量接不上”,只背定义就不够了。要先判断丢掉的是数据库恢复能力,还是外部订阅需要的变更历史。
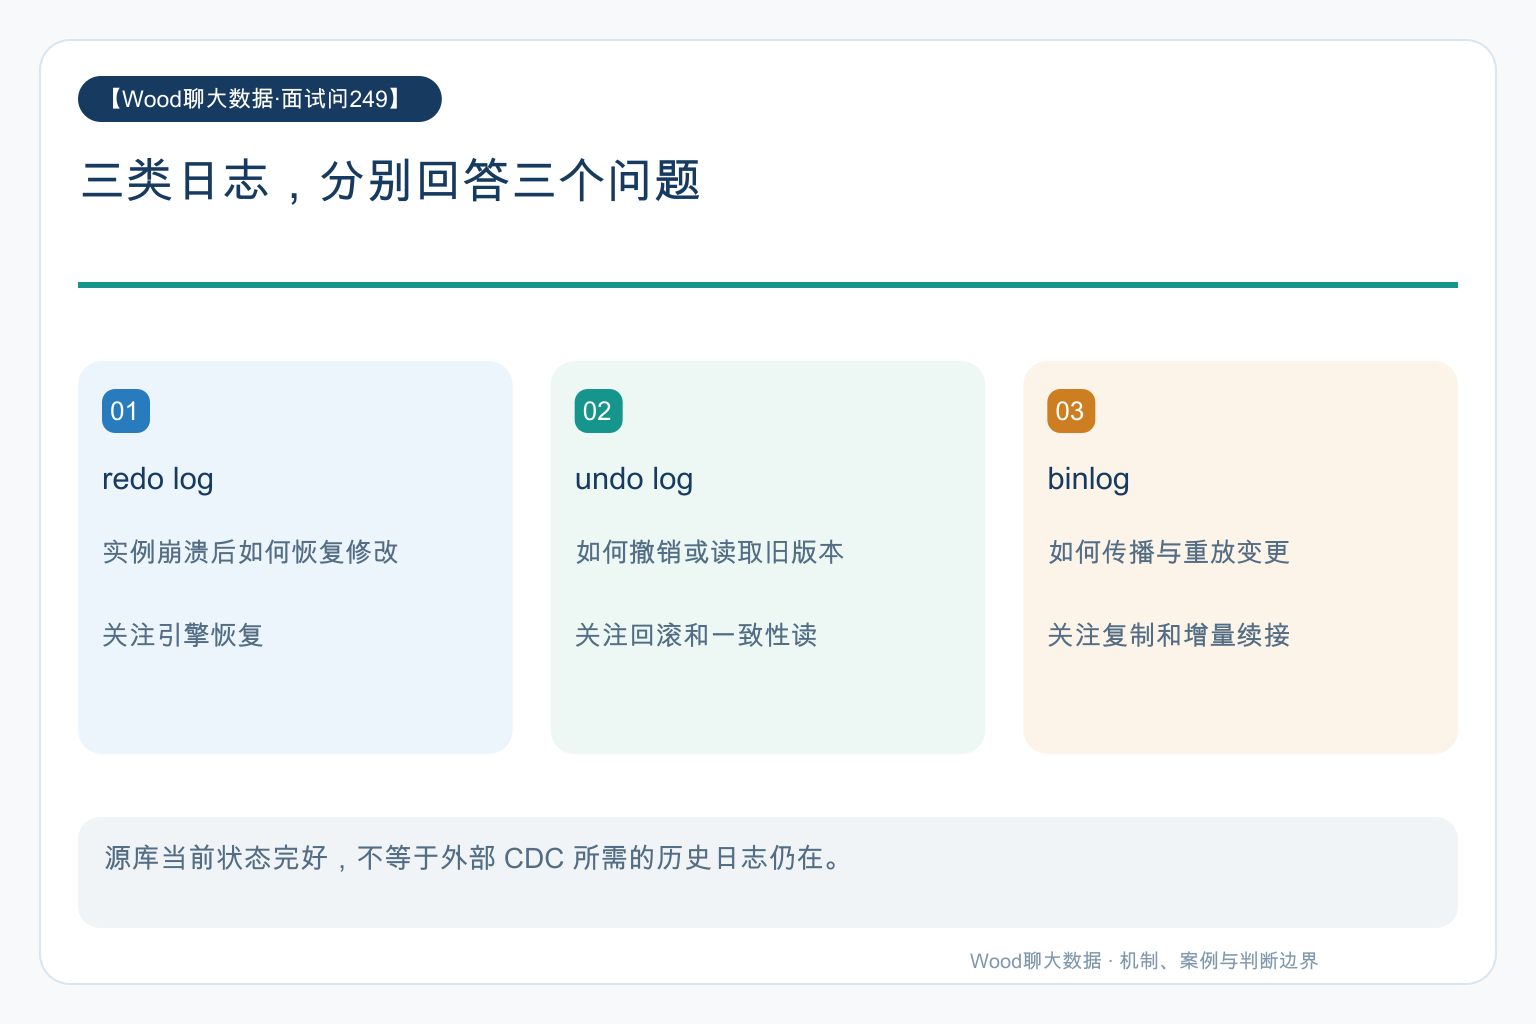
redo 面向引擎恢复,undo 服务回滚与一致性读,binlog 记录用于复制和增量恢复的变更;三者的职责与保留边界不同。
redo 关注崩溃后怎样恢复数据修改
对 InnoDB 来说,数据页修改与数据文件刷盘不是每次都同步完成。redo 记录恢复所需的修改信息,让实例异常退出后能够重放相关变化。它属于存储引擎内部恢复机制,而不是面向业务订阅者的通用事件流水。
WAL 强调先把相关日志持久化,再允许对应脏数据页写回等恢复顺序。不要把它简化成“redo 只在事务提交时才开始产生”,修改过程中就会生成日志;提交持久性还需要结合刷盘配置和存储系统保证来讨论。
undo 不只是失败时往回改
undo 保存撤销修改所需的信息,可以用于事务回滚,也能让一致性读沿历史版本找到应当可见的数据。因而事务提交不意味着所有相关旧版本立即没有用途,仍然活跃的读视图可能需要它们。
长事务或长时间一致性读取可能延长旧版本保留,带来清理压力。这与 CDC 消费延迟是不同问题:前者关注数据库内部读视图与版本回收,后者通常关注外部订阅位点对应的 binlog 是否还在。
binlog 关注变更怎样传播与重放
binlog 位于 MySQL Server 层,记录数据库变化事件,用于复制,也可在备份基础上执行时间点恢复。它并不等于普通查询日志,不能默认里面包含所有 SELECT 请求。
基于行的日志记录行变更,基于语句和混合格式有各自表达方式。常见 MySQL CDC 连接器会要求或依赖行格式,并对行镜像、权限、主键及 DDL 支持提出条件。具体要求应按连接器与 MySQL 版本核对,不要只确认 log_bin 已开启就结束验收。
为什么常见 CDC 不直接订阅 redo
CDC 需要消费可定位的变更事件,并处理事务边界、表结构及来源位点。binlog 是 MySQL 复制生态使用的变更通道,常见连接器据此读取;redo 的内部表示与恢复目标不同,不能把它当成同等可替换的订阅接口。
这并不是说所有数据库 CDC 都读一种叫 binlog 的东西。不同数据库可能基于各自的事务日志和解码接口提供能力。面试回答要限定在 MySQL 与具体连接器,不要把产品名当成所有系统的通用原理。
一个典型场景:源库正常,同步却无法续接
比如同步任务暂停后恢复,保存的 binlog 位点已被清理。开发看到源库当前表数据完好,就以为调整连接参数即可继续。实际上当前状态不能自动重建暂停期间的全部更新、删除和中间变更。
原监控只看源数据库是否可连接,没有比较最老保留日志与消费进度。真正需要的是明确可续读窗口,并让日志保留覆盖预期停机、修复和追赶时间。窗口不足时要告警,而不是等连接器启动失败才发现。
已经形成历史缺口时,可以评估可用归档、兼容的副本日志,或重新执行一致性快照与增量衔接。不能随意把位点改到最新,跳过中间变化后继续宣称数据完整;最终还需要按表和业务键对账。
三份日志的职责不同,但提交过程需要协调
在启用 binlog 的 InnoDB 事务场景中,引擎提交和 binlog 之间需要协调,以避免恢复后的引擎状态与复制日志不一致。理解这个目标,比机械背一串不含故障点的“写日志顺序”更重要;底层实现和配置要按版本解释。
排障时分别提问:实例能否恢复、事务看到哪个版本、外部消费能否续接。三个问题对应不同证据,不应靠其中一个检查通过,就推断其他两项也有保障。