SQL GROUPING SETS、ROLLUP 和 CUBE 有什么区别?
面试怎么回答
GROUPING SETS 用来精确列出需要的分组组合;ROLLUP 按字段顺序生成从明细到上级再到总计的层级汇总,N 个元素产生 N+1 组;CUBE 生成所有维度组合,N 个维度最多产生 2^N 组。实际选择时我会看报表需要哪些粒度,并用 GROUPING 或 GROUPING_ID 区分汇总 NULL 与真实 NULL,同时评估组合数量和执行成本。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一张销售报表同时要展示“地区 + 商品”明细、地区小计、商品小计和全局总计。
最直接的写法,是写四段 GROUP BY 再 UNION ALL。但 SQL 越来越长,扫描和维护成本也跟着上升。
这时可以使用高级分组:GROUPING SETS 精确指定需要的组合,ROLLUP 生成有层级顺序的小计,CUBE 生成所有维度组合。
GROUPING SETS:我只要这些分组组合
SELECT
  region,
  product,
  SUM(amount) AS sales_amount
FROM sales
GROUP BY GROUPING SETS (
  (region, product),
  (region),
  (product),
  ()
);
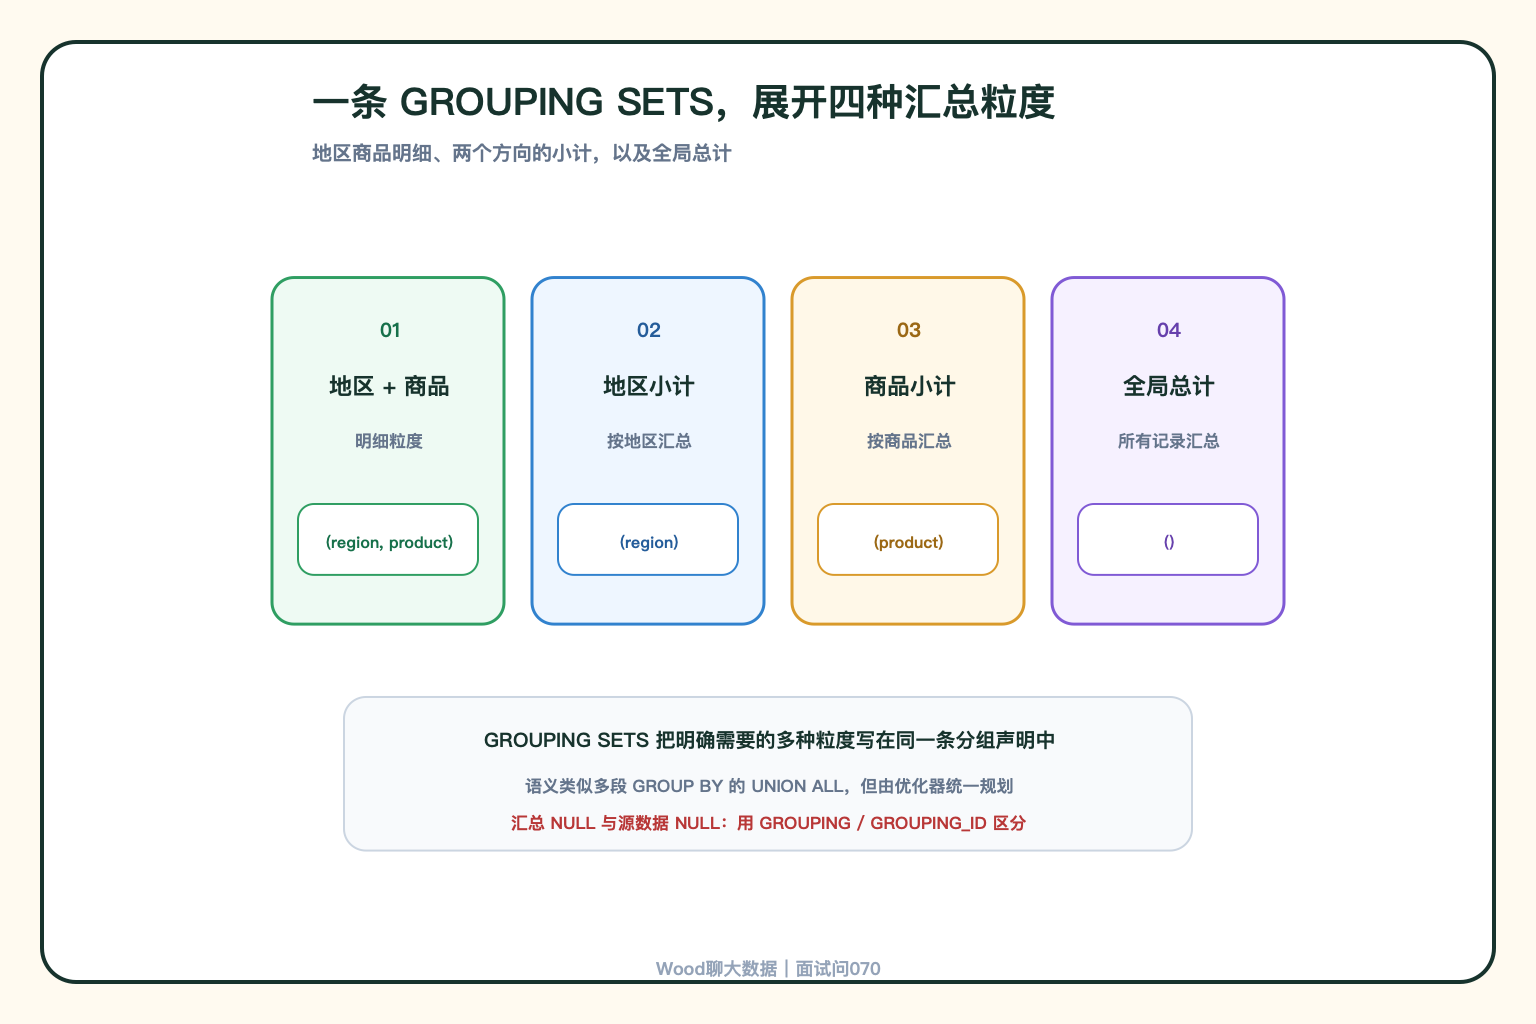
这里明确要求四种粒度:
(region, product):地区 + 商品明细(region):地区小计(product):商品小计():全局总计
它的语义类似把四段不同 GROUP BY 的结果 UNION ALL 到一起,但写法更集中,优化器也可以统一规划执行。
ROLLUP:按照层级逐级向上汇总
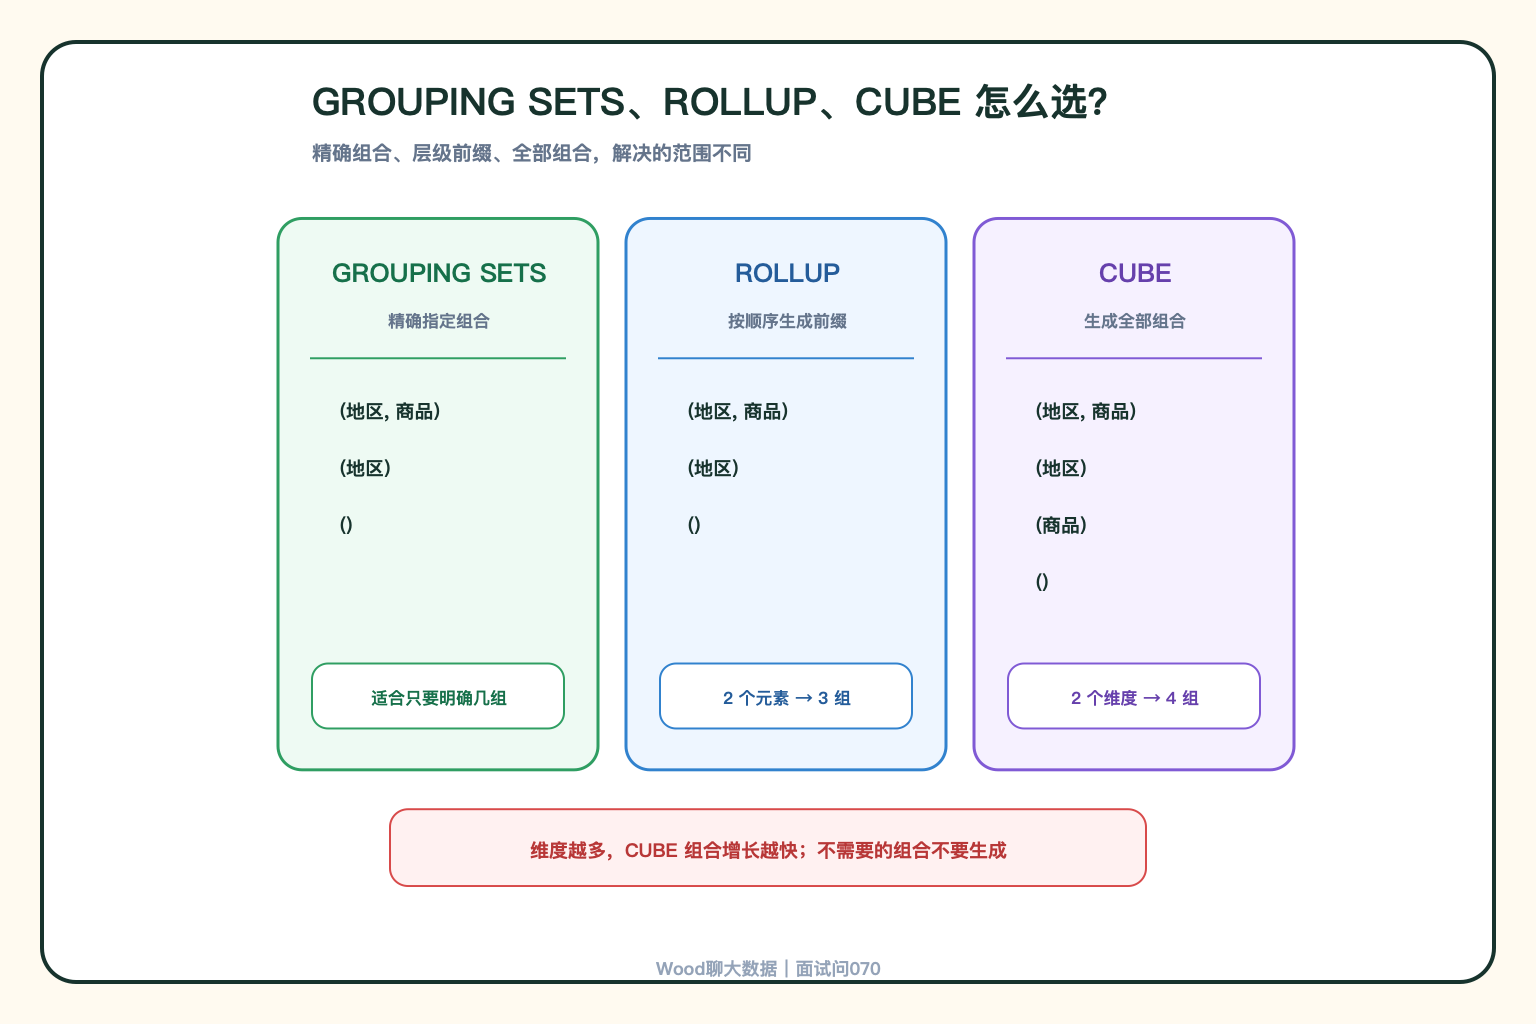
GROUP BY ROLLUP(region, product)等价于:
(region, product)
(region)
()
ROLLUP 会按字段顺序生成前缀层级,适合“年—月—日”“大区—省份—城市”这种自然钻取路径。
注意字段顺序非常重要。ROLLUP(region, product) 会产生地区小计,但不会单独产生商品小计。
CUBE:生成所有维度组合
GROUP BY CUBE(region, product)会产生:
(region, product)
(region)
(product)
()
两个维度有 4 种组合;N 个维度理论上会生成 2^N 种分组组合。
所以 CUBE 适合多角度探索,但维度一多,结果规模和计算成本会快速增长,不能看到“自动生成全部组合”就无脑使用。
结果里的 NULL 到底代表什么?
高级分组输出中,汇总层级缺少的维度通常会显示为 NULL。
但源数据本身也可能存在真实 NULL。直接写 COALESCE(region, '全部'),可能把真实缺失值和汇总行混在一起。
更稳妥的做法是使用目标引擎支持的 GROUPING() 或 GROUPING_ID() 判断该字段是不是因为分组层级而被置空,再给汇总行展示“全部”或“小计”。
实际怎么选?
- 只需要几个明确组合:使用 GROUPING SETS
- 存在固定层级向上汇总:使用 ROLLUP
- 确实需要所有维度组合:使用 CUBE
- 维度很多但只展示少数小计:不要用 CUBE,明确列出 GROUPING SETS
不同引擎在具体语法、函数名称和执行计划上可能存在差异,上线前要用 EXPLAIN 和实际数据量验证,而不是假设高级语法一定只扫描一次、一定更快。
高级分组的价值,是用一条清晰的分组声明表达多种汇总粒度,而不是为了炫技。