SQL 如何实现每个分组的 Top N?
面试怎么回答
我会先把数据聚合到题目要求的粒度,例如品类加商品,再用窗口函数按品类分区、按指标降序排名。固定返回 N 行用 ROW_NUMBER,需要保留并列用 RANK 或 DENSE_RANK,并补充稳定排序字段。大数据量下还会先过滤和局部聚合,关注超大分组带来的 Shuffle 与倾斜。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
写出窗口函数只是第一步,面试官通常还会追问并列、去重和性能。
分组 Top N 的核心是先确定统计粒度,再选择 ROW_NUMBER、RANK 或 DENSE_RANK 表达并列语义。
先聚合到目标粒度
原始明细可能是一单多行。若题目要求商品销售额,应先按品类和商品聚合,再对聚合结果排名。直接在订单明细上排名,得到的是订单行 Top N,不是商品 Top N。
排名函数表达业务语义
ROW_NUMBER 强制每组只保留 N 行;RANK 遇到并列会跳号;DENSE_RANK 并列但不跳号。若第三名有两个并列商品,是否返回四行,必须由业务决定。
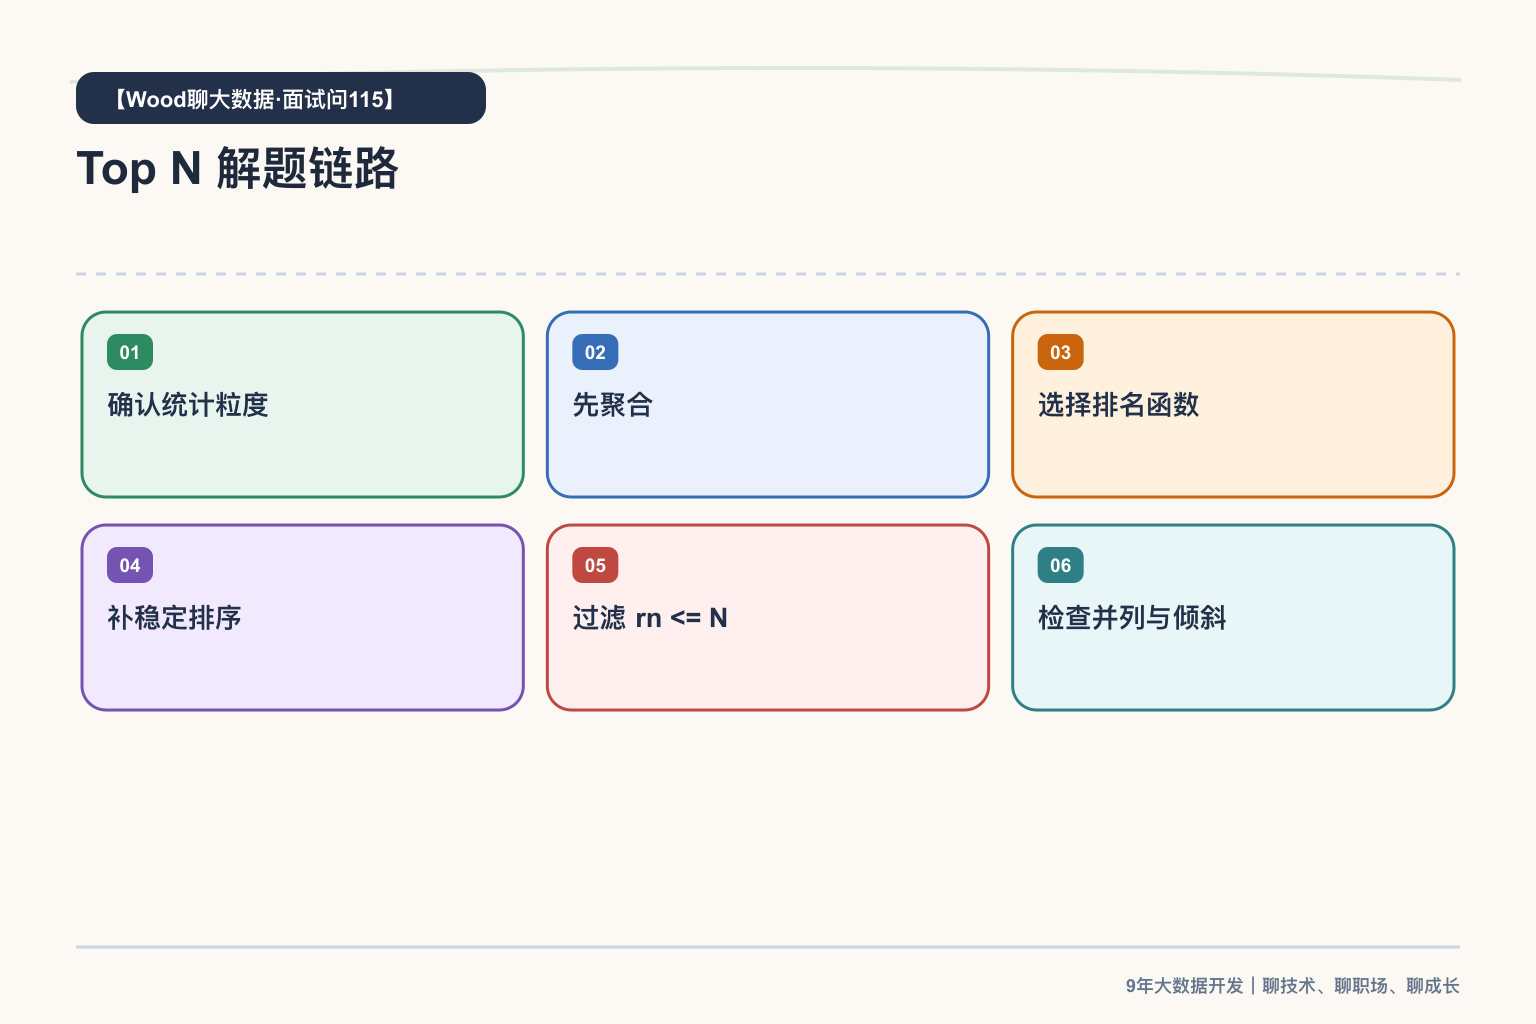
排序必须稳定
只按销售额排序时,并列记录的先后可能不稳定。需要补充商品 ID、最近销售时间等确定性字段;NULL、退款和负数金额也要提前定义排序规则。
大数据量先减再排
窗口排序通常需要按分组键 Shuffle,并在组内排序。可以先做分区裁剪、列裁剪和局部聚合,控制超大分组;热点品类还可能产生数据倾斜,需要单独拆分。
为什么不能只回答概念?
“浅答案:PARTITION BY 后直接排名”之所以常见,是因为它在理想数据和单次执行里往往说得通。但生产环境会加入数据规模、异常值、并发、版本、失败重试和下游口径,这些条件一变化,只记住术语就很容易给出错误结论。
所以我会把 先聚合到目标粒度、排名函数表达业务语义、排序必须稳定、大数据量先减再排 串成一条完整链路。最终判断标准不是某个函数或配置是否出现,而是能否稳定得到可解释、可验证、可恢复的业务结果。
落地时我会检查什么?
- 输入边界:确认数据范围、时间口径、主键和异常值是否符合假设。
- 执行过程:观察分区、并行度、状态、Shuffle 或资源变化,验证方案是否真正生效。
- 输出结果:用行数、唯一性、关键指标和样本明细证明结果正确,而不是只看任务成功。
- 失败恢复:说明重跑、回滚、版本兼容和责任人,避免一次成功后无人维护。
这些检查不一定全部写进一条 SQL 或一个任务,但面试时能主动补充,说明你回答的不是背诵题,而是在描述一套可上线的工程方案。
一个典型场景
一个典型反例是直接对订单明细做 ROW_NUMBER,结果同一个爆款商品占据前三名的多个位置。开发看到 SQL 确实每组返回三行,以为已经正确;但统计粒度错了。改为先按商品聚合,再排名,并明确退款抵扣和并列规则后,结果才与榜单口径一致。
Top N 先问“谁和谁比”,再问“并列怎么算”。