SQL 怎么统计跨天在线时长?按开始日期分组为什么会算错?
面试怎么回答
我会把会话看成左闭右开的时间区间,与每个业务日的起止区间求交,交集开始取较晚值、结束取较早值,再累计秒数。先统一时区,并确认指标按会话时长还是用户实际在线时长,后者需合并重叠区间。未结束会话使用固定观察时点并标注暂估,不能用不断变化的当前时间让历史结果不可复现。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
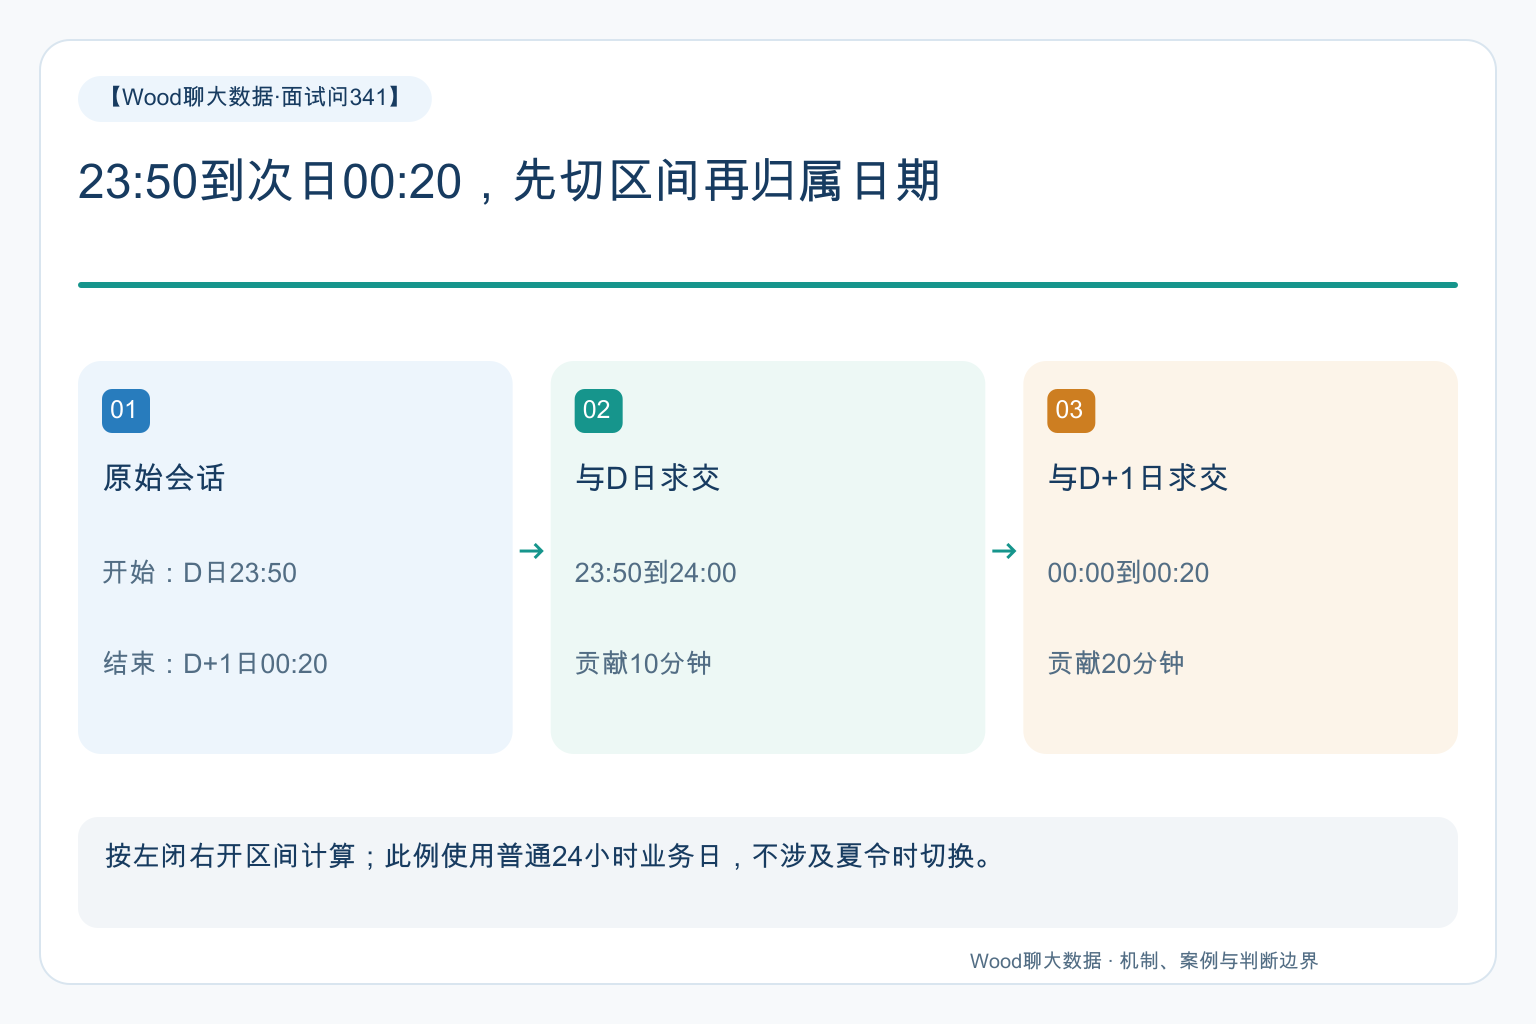
用户23点50分上线,次日0点20分下线。昨天应记10分钟,今天应记20分钟;如果GROUP BY上线日期,昨天却会得到完整30分钟。SQL聚合没有错,输入粒度先错了。
按天统计区间时长,应先与各业务日区间求交再汇总;跨日切分、重叠去重和未结束区间要分别处理。
会话是区间,日期只是统计桶
一条会话记录拥有开始与结束,不是发生在某个瞬间的点事件。把开始日期当作全部时长归属,相当于把跨天的后半段移动到了前一天。
可以把业务日也表示成区间:当天起点到次日起点。会话与某天有交集,才向这天贡献时长;恰好在午夜结束的会话,不应在次日多算一段。
左闭右开有助于统一边界:会话开始包含、结束不包含。连续两段首尾相接时,边界不被重复覆盖,但具体业务仍应统一采用同一种约定。
求交公式很简单,前提要完整
交集开始取会话开始和业务日起点中的较晚者,交集结束取会话结束和业务日终点中的较早者,只有结束大于开始才有正时长。
以下 PostgreSQL 17 示例假设sessions已去重且起止有效,calendar_bounds每个业务日仅一行,两边都使用同一类型的绝对时刻:
SELECT c.biz_date,
       SUM(EXTRACT(EPOCH FROM
           LEAST(s.end_at, c.day_end)
           - GREATEST(s.start_at, c.day_start)
       )) AS session_seconds
FROM sessions s
JOIN calendar_bounds c
  ON s.start_at < c.day_end
 AND s.end_at > c.day_start
GROUP BY c.biz_date;
这里得到的是会话时长之和。如果同一用户两台设备重叠在线,它们会重复贡献重叠时段;这不是公式错误,而是指标仍停留在会话口径。
实际在线时长,要先处理重叠
若需求是每个用户实际覆盖的在线时间,应按用户合并重叠区间,再与业务日相交。不能只按会话ID去重,因为两个合法会话也可能在时间上重叠。
合并区间时不能总是只看紧邻前一条的结束时间,嵌套区间可能需要参考此前最大结束边界。这个步骤解决的是覆盖集合,不是随便选一条最早记录。
如果业务恰恰要统计设备资源占用,则同用户多设备时长相加可能是正确的。先定义对象,再决定是否合并,不能把去重当成默认更准确。
时区和未结束会话是另外两道边界
业务日的起止应按业务时区生成,再转换成绝对时刻比较。存在夏令时的日期未必恰好二十四小时,不能总用固定秒数替代下一天边界。
结束时间缺失可能是用户仍在线,也可能是下线事件漏采。可以使用固定的观察终点计算暂估值,但应记录版本、上限规则和后续修正方式。
结束早于开始、超长会话和缺失用户标识应单独校验。直接把负时长截成零,会掩盖时间解析或事件关联问题,不能算作修复。
一个典型场景:凌晨时长总是偏低
假设日报显示前一天深夜在线时长偏高,第二天凌晨偏低,团队最初认为用户使用习惯发生变化。总时长对账却始终能对上。
实际是全部时长按会话开始日归属,跨午夜的部分被移到了前一天。旧校验只比整段周期总和,没有按日期抽查跨界会话,所以没有发现时间归属错误。
修正后用跨午夜、整天覆盖、恰好边界、同用户重叠和未结束等样本验证。对有效且完整覆盖统计范围的单一会话,各天贡献之和应等于原会话在范围内的总时长。
不要为求交制造无边界的笛卡尔积
实现时先限定日历范围和可能相交的会话,再按需要做区间匹配。将全部历史会话与全部历史日期展开后再过滤,可能产生巨大的中间结果。
长会话与异常时间必须有业务核验,不能为性能随意截断真实时长。正确性口径与执行优化分开讨论,才能解释为什么这条SQL既算得对,也有可控成本。