SQL GROUP BY 和窗口函数有什么区别?
面试怎么回答
GROUP BY 会把多条明细压缩到分组粒度,适合生成部门、日期或渠道级汇总;窗口函数通过 OVER 在相关行集合上计算,但通常保留当前结果集的每一行,适合排名、累计和明细对比。两者可以组合,逻辑上先分组聚合,再对聚合结果开窗口。使用时最重要的是先确认输入粒度、输出粒度以及窗口实际看到的是明细还是汇总结果。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
现在有一张员工明细表,既要展示每个员工的工资,又要展示他所在部门的平均工资。
用 GROUP BY 可以算出部门平均值,却丢掉了员工明细;用窗口函数则能把部门平均值放回每一行。
两者最核心的区别是:GROUP BY 会改变结果粒度,把多行压缩成一行;窗口函数在一个窗口内计算,但通常保留当前结果集的每一行。
GROUP BY:把明细收敛到分组粒度
SELECT
  dept_id,
  AVG(salary) AS avg_salary
FROM employee
GROUP BY dept_id;
原表粒度是“一行一个员工”,聚合后变成“一行一个部门”。
这时 SELECT 中通常只能出现分组字段和聚合结果,因为同一个部门有多个员工,数据库无法判断应该返回哪一个员工字段。
GROUP BY 适合回答:
- 每个部门的总工资是多少
- 每天的订单量是多少
- 每个渠道的收入是多少
它的目标是产出新的汇总粒度。
窗口函数:在保留行的基础上计算组内指标
SELECT
  employee_id,
  dept_id,
  salary,
  AVG(salary) OVER (PARTITION BY dept_id) AS dept_avg_salary
FROM employee;
每个员工仍然保留一行,只是多了一列部门平均工资。
窗口函数适合回答:
- 每个员工与部门平均工资的差值
- 每个用户最近一次行为
- 每个商品在品类内的排名
- 每天收入以及累计收入
它的目标是在当前粒度上补充组内上下文。
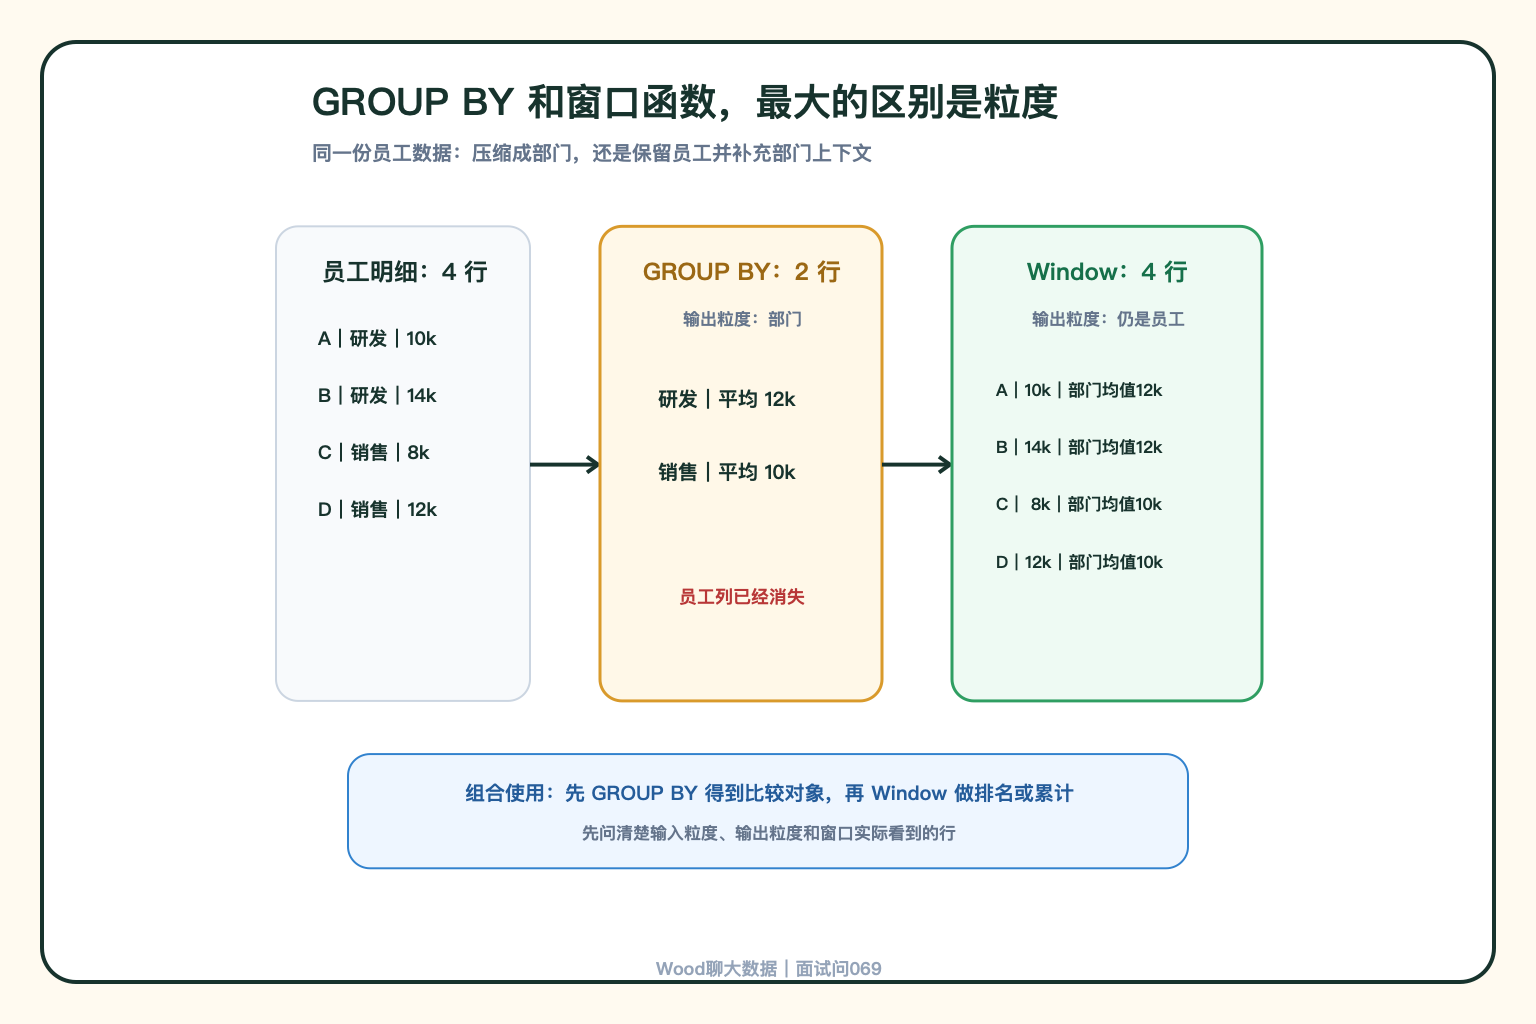
两者可以一起使用吗?
可以,但要先弄清窗口函数看到的是什么数据。
SELECT
  dt,
  channel,
  SUM(amount) AS channel_amount,
  SUM(SUM(amount)) OVER (PARTITION BY dt) AS day_amount
FROM order_detail
GROUP BY dt, channel;
这条 SQL 先把订单明细聚合成“日期 + 渠道”粒度,再在聚合结果上计算当天总收入。
窗口函数逻辑上发生在 GROUP BY 和普通聚合之后,因此这里窗口中的每一行已经不是原始订单,而是一条渠道汇总记录。
为什么窗口函数不能直接写在 WHERE?
下面这种写法通常不合法:
SELECT
  *,
  ROW_NUMBER() OVER (
    PARTITION BY user_id
    ORDER BY update_time DESC
  ) AS rn
FROM user_event
WHERE rn = 1;
原因是 WHERE 过滤发生时,窗口结果还没有计算出来。
通用做法是先在子查询或 CTE 中计算 rn,再在外层过滤。部分引擎支持 QUALIFY,可以直接过滤窗口结果,但要确认目标引擎是否支持。
一个常见误区
需求是“每个渠道收入最高的 3 个商品”,有人先按渠道 GROUP BY,结果商品粒度已经消失;也有人直接使用窗口函数,却没有先把订单明细汇总到商品粒度,排名变成了订单行排名。
正确顺序通常是:
- 先把数据聚合到“渠道 + 商品”粒度
- 再对各渠道内的商品收入做窗口排名
- 最后在外层保留 Top 3
先确定最终比较对象的粒度,再决定在哪一层 GROUP BY、在哪一层开窗口。