SQL 联合索引的最左匹配怎么理解?
面试怎么回答
联合 B-tree 索引按列顺序形成多级有序结构。前导列的等值条件,加上第一个非等值条件,通常决定主要扫描边界;更右侧列仍可能用于索引内过滤或覆盖读取,不应简单称为全部失效。设计时我会结合高频查询、选择性、排序、覆盖与写入成本确定列顺序,并通过执行计划和实际扫描行数验证。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
明明建了一个三列联合索引,查询还是扫描了很多数据。
很多人第一反应是索引失效,但真正的问题往往是列顺序和查询模式不匹配。
联合索引的关键不是背诵最左前缀,而是理解索引顺序如何缩小扫描范围、过滤记录并匹配排序。
联合索引本质上按多列有序
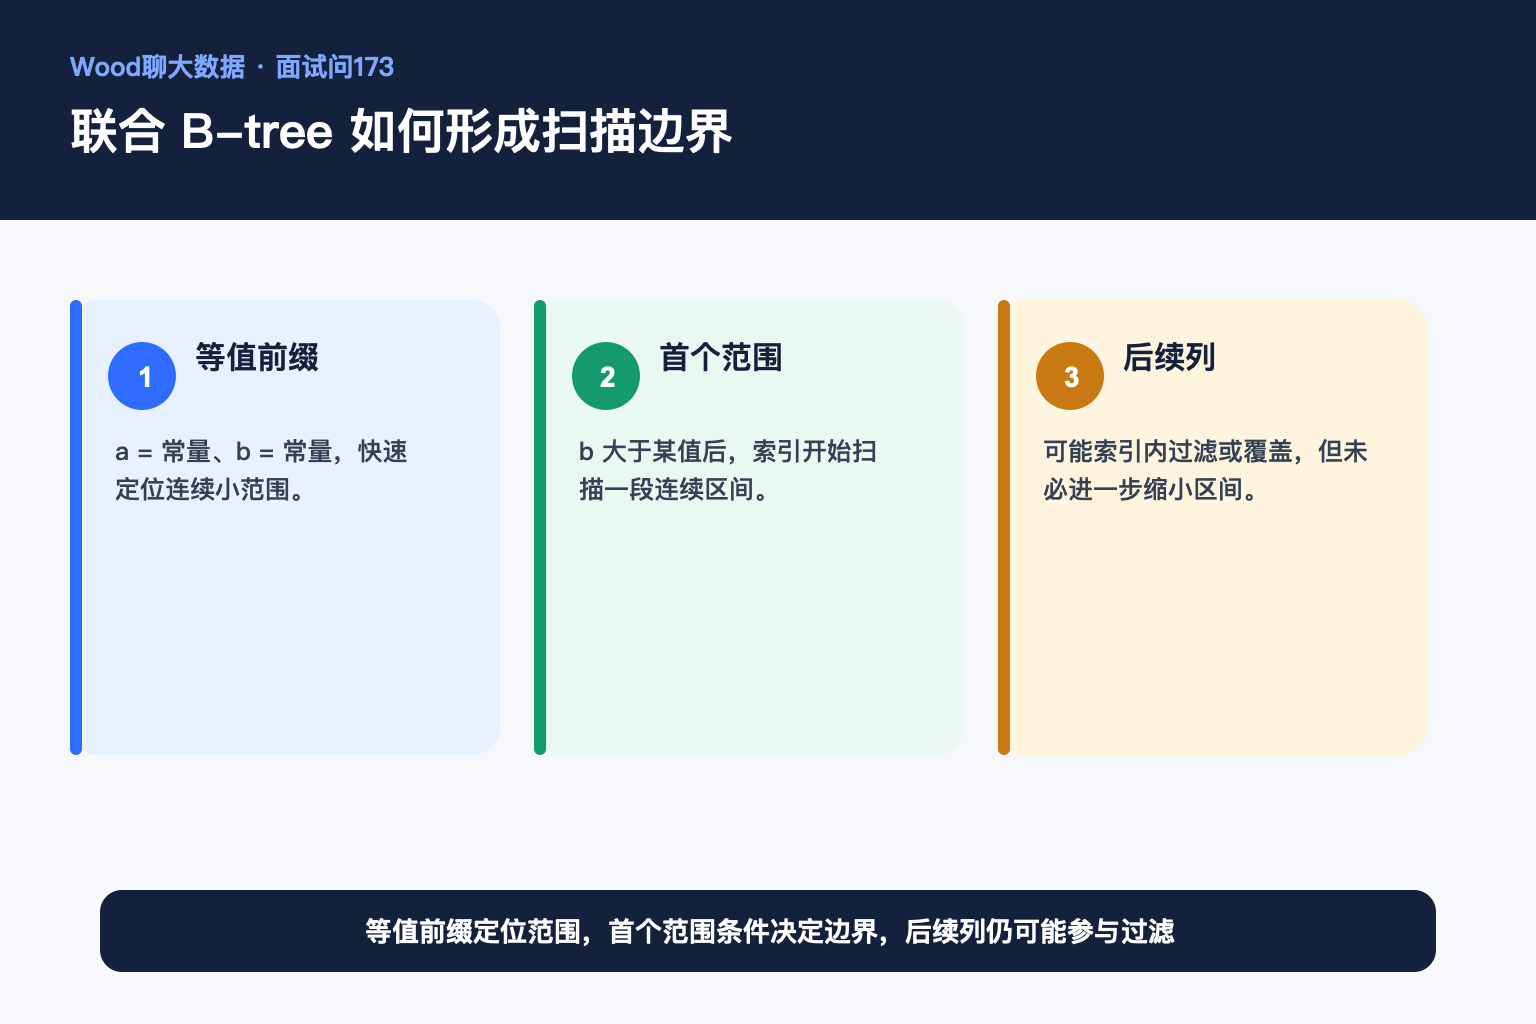
以 B-tree 联合索引(a,b,c)为例,索引先按 a 排序,a 相同时再按 b,最后按 c。查询能否快速定位,取决于条件能否利用这套有序结构形成连续、较小的扫描区间,而不只是 SQL 中有没有写到索引列。
为什么前导等值列最重要
当条件是 a 等于常量、b 等于常量时,可以快速定位到很窄的键范围。若完全跳过 a,只过滤 b,传统扫描很难直接找到一个连续区间。部分数据库和版本可能使用 Skip Scan 等优化,所以不能简单说跳过首列就绝对不用索引,但代价和适用条件会变化。
范围条件之后发生了什么
对于 a 等于常量、b 大于某值、c 等于常量,a 和 b 通常用于确定索引扫描边界,c 仍可能在索引内部过滤并减少回表,却不一定继续缩小连续扫描区间。面试里把它说成范围列后所有列完全失效,也不够准确。
列顺序还要考虑排序与覆盖
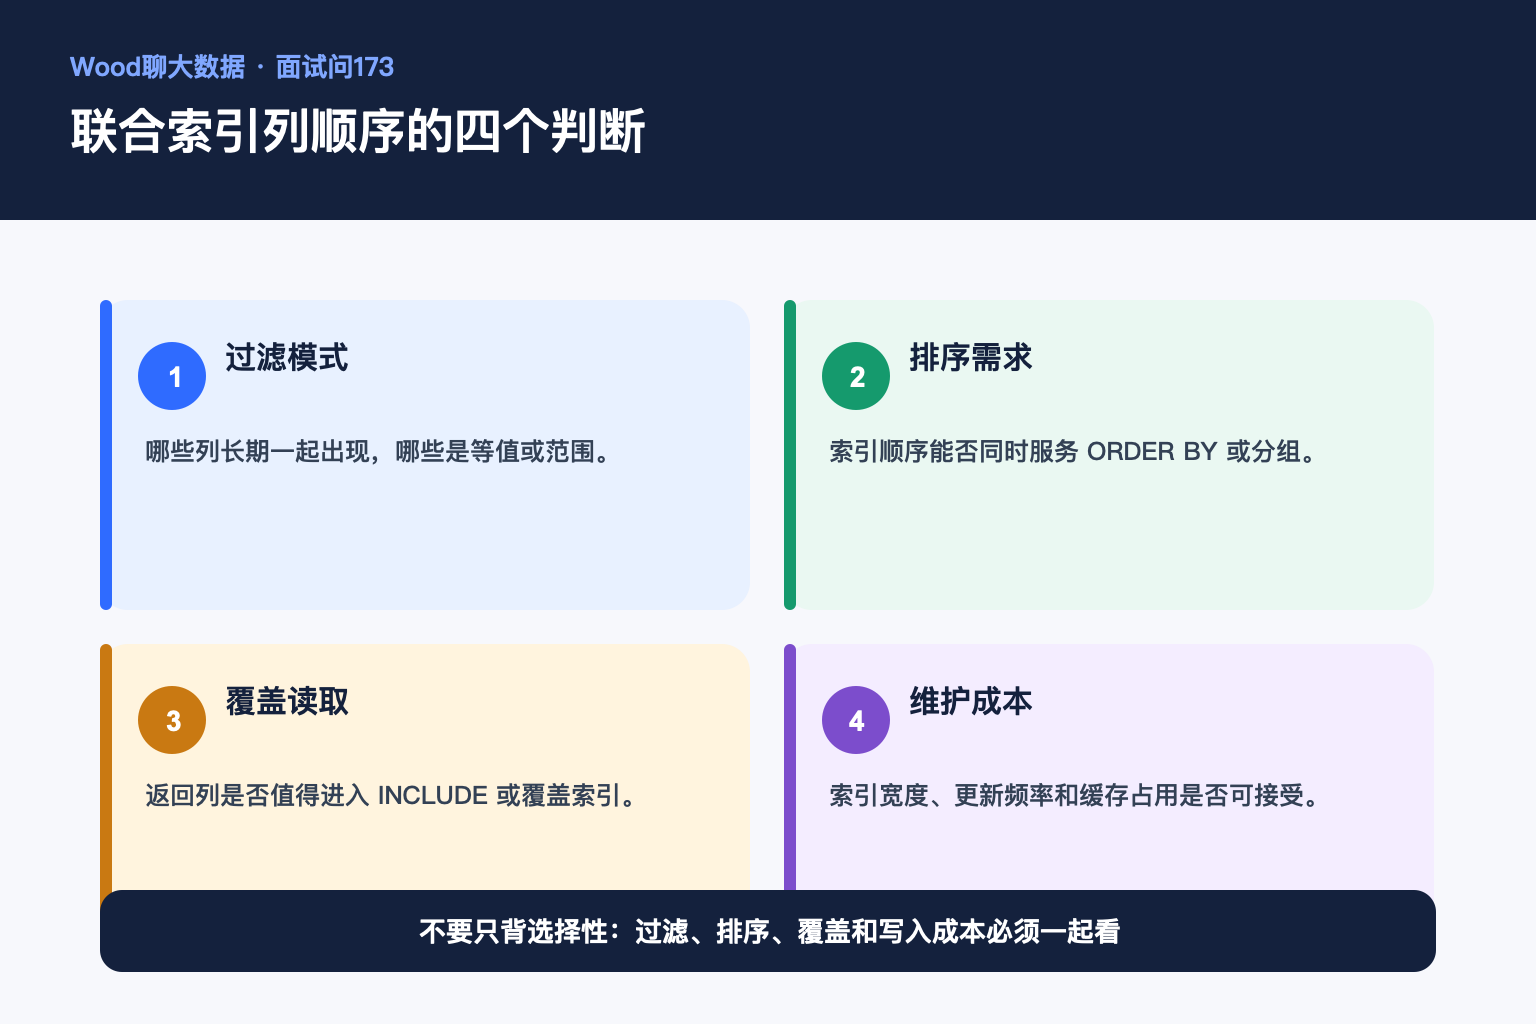
高频等值过滤列通常放前面,但不能只按区分度机械排序。还要看 ORDER BY、GROUP BY、查询覆盖率、写入成本和索引体积。把返回列放入覆盖索引可能减少回表,但索引越宽,更新和缓存成本越高。
一个典型场景
订单表常按 tenant_id 和 created_at 查询,并按时间倒序分页。若索引只建(created_at,tenant_id),跨租户时间范围很大时扫描会被放大。更合适的顺序通常是先用 tenant_id 定位租户,再按 created_at 做范围和排序,但仍要用真实数据分布与执行计划验证。
参考资料
- PostgreSQL Multicolumn Indexes:https://www.postgresql.org/docs/current/indexes-multicolumn.html