SQL 递归 CTE 怎么处理层级和路径?
面试怎么回答
递归 CTE 由锚点项和递归项组成:锚点给出起始集合,递归项基于上一轮结果继续查父子关系,直到没有新行。处理层级问题时我会携带 level、root_id 和 path;使用 UNION ALL 时显式增加方向、终止条件、最大深度和环路检测。最后还要检查索引是否覆盖 parent_id 或关联键,因为逻辑正确不代表多轮连接成本可控。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一棵组织树只有几千行,查询却一直跑不完。
问题通常不在数据量,而在递归逻辑把环路当成了层级。
递归 CTE 真正难的不是语法,而是锚点、递归关系、终止条件和环路控制。
递归 CTE 是迭代,不是一次性自连接
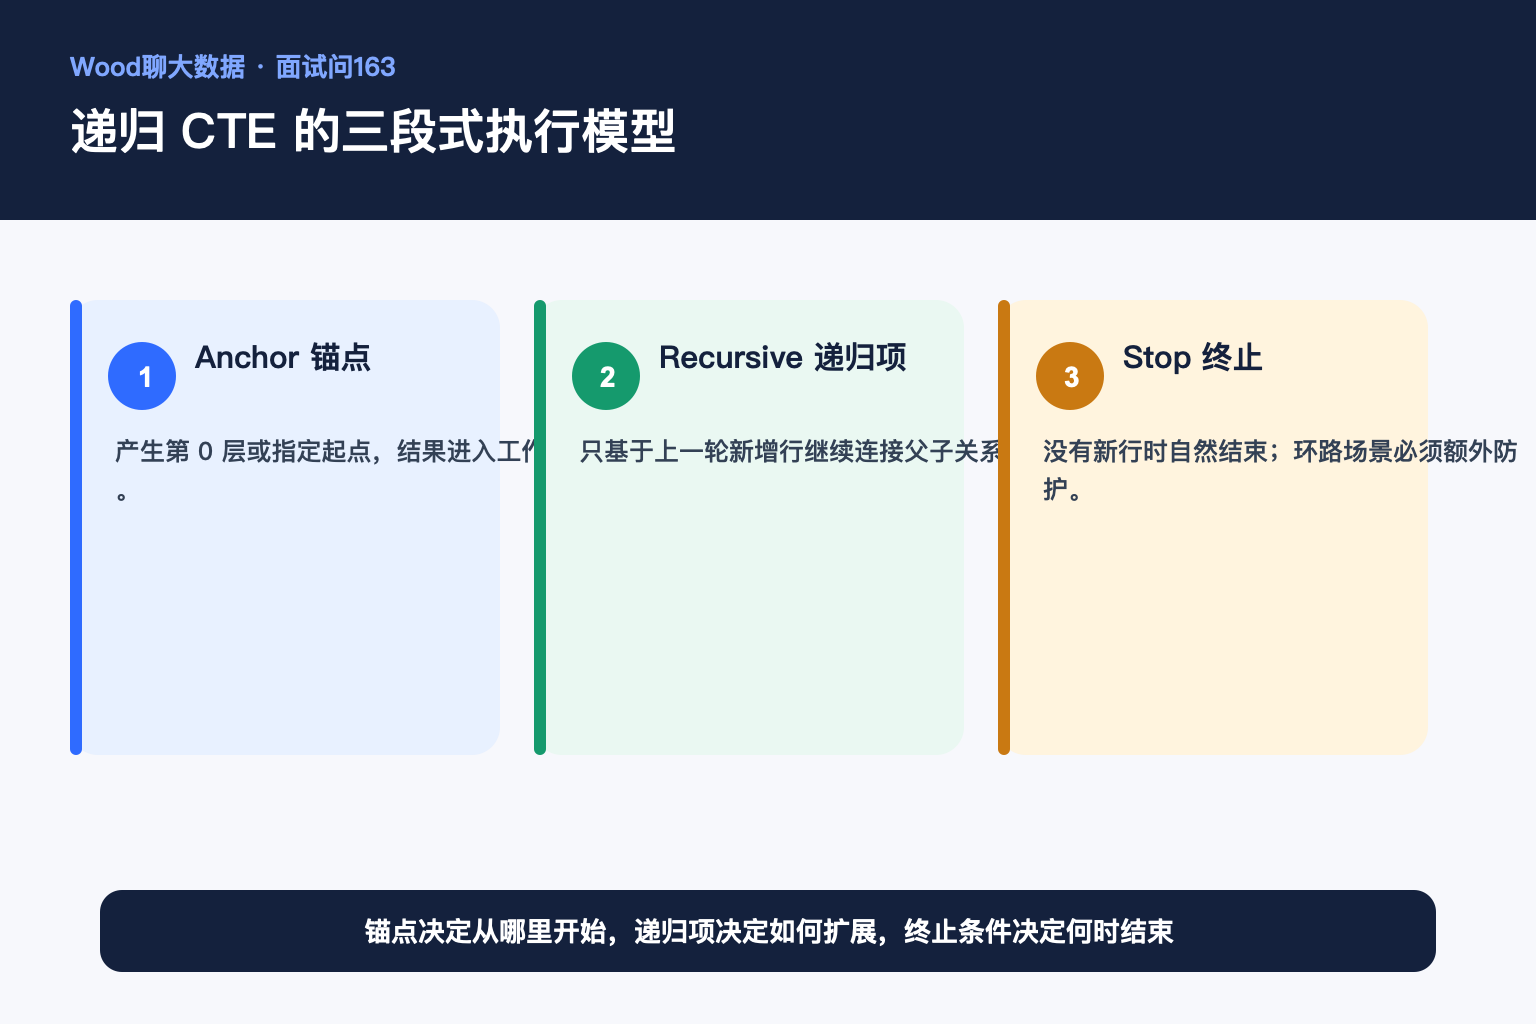
递归 CTE 通常由锚点查询和递归查询两部分组成。锚点先产生第一批行,递归项再引用上一轮结果生成下一批行,直到某一轮不再产生新记录。它适合组织架构、商品类目、依赖关系和图路径等未知深度问题。
先把锚点和父子方向讲清楚
查下级时,锚点通常是指定部门或根节点,递归项用当前节点的 id 连接子节点的 parent_id。查上级链路时方向相反。方向一旦写反,不仅结果错误,还可能把本应收敛的查询扩散成全表扫描。
层级和路径要在递归过程中携带
仅返回节点 id 很难解释结果。生产 SQL 往往同时维护 level、path 和 root_id。level 用于限制深度和排序,path 用于展示完整链路,也能辅助检测某个节点是否已经出现。
UNION ALL 快,但必须自己保证终止
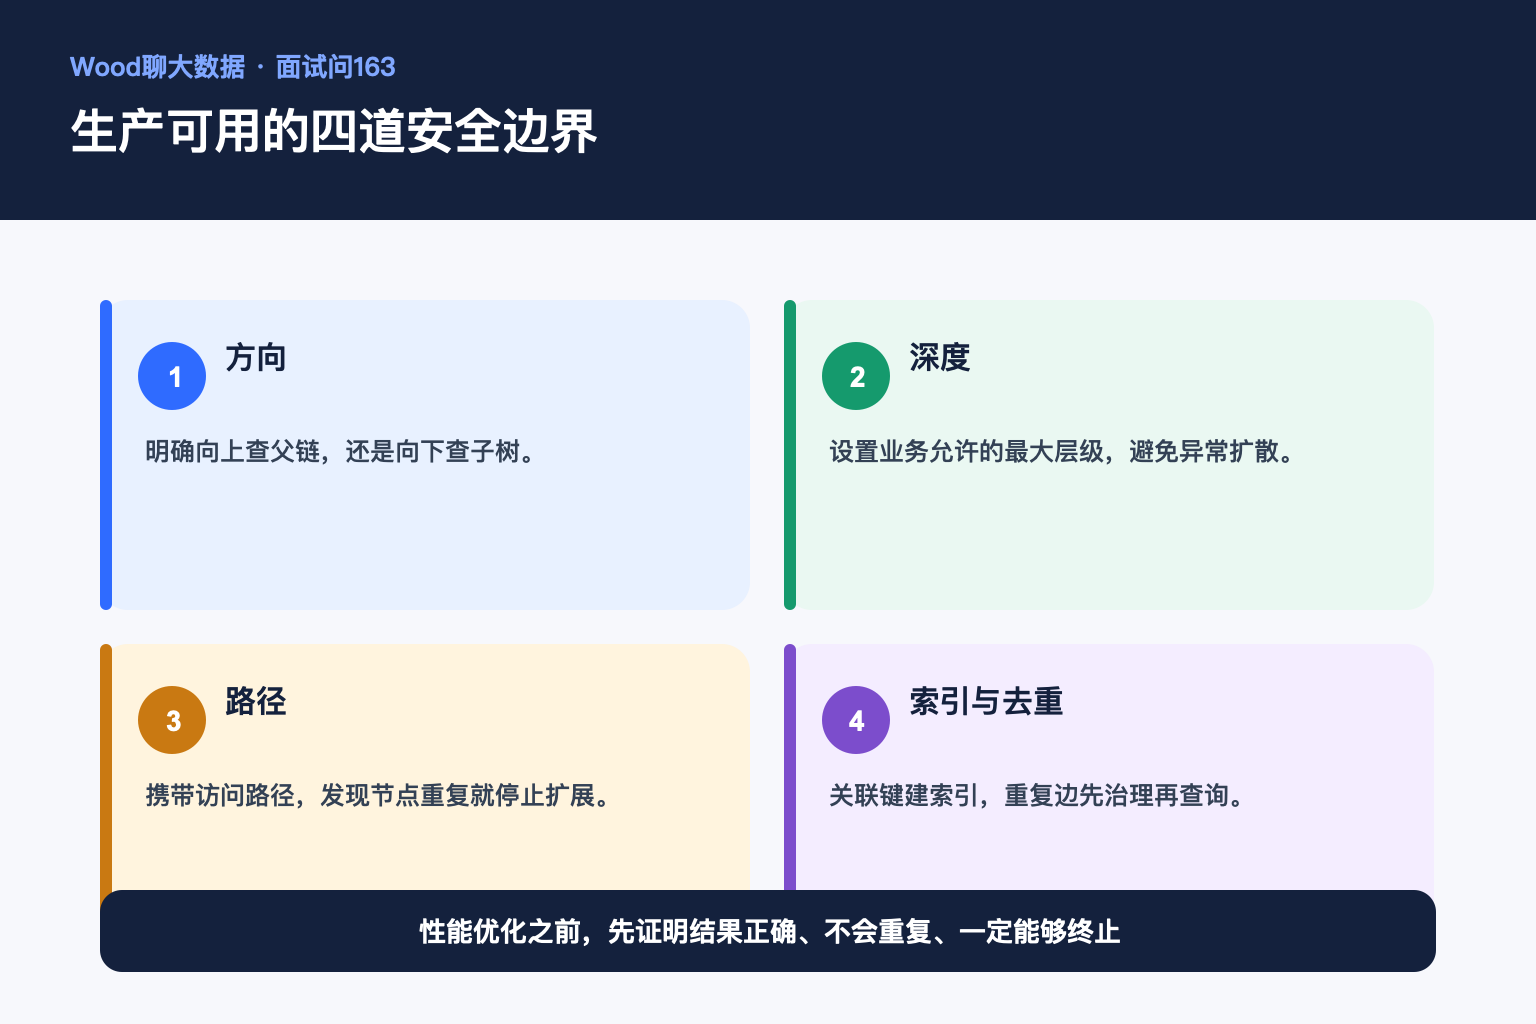
UNION ALL 不做全局去重,性能通常更好,但重复边和环路会被持续放大。UNION 可以消除完全相同的行,却无法解决包含 level 或 path 后每轮都不同的环。因此应优先修复脏数据,并增加最大深度、访问路径判断或数据库提供的 CYCLE 能力。
一个典型场景
商品类目表中,A 的父级是 B,B 的父级又被错误改成 A。查询类目路径时,两行会无限互相生成。比较稳妥的做法是把访问过的节点组成 path,下一轮连接前先判断目标节点是否已在 path 中,同时设置合理的最大层级作为最后防线。
参考资料
- PostgreSQL WITH Queries 文档:https://www.postgresql.org/docs/current/queries-with.html