SQL 的逻辑执行顺序是什么?
面试怎么回答
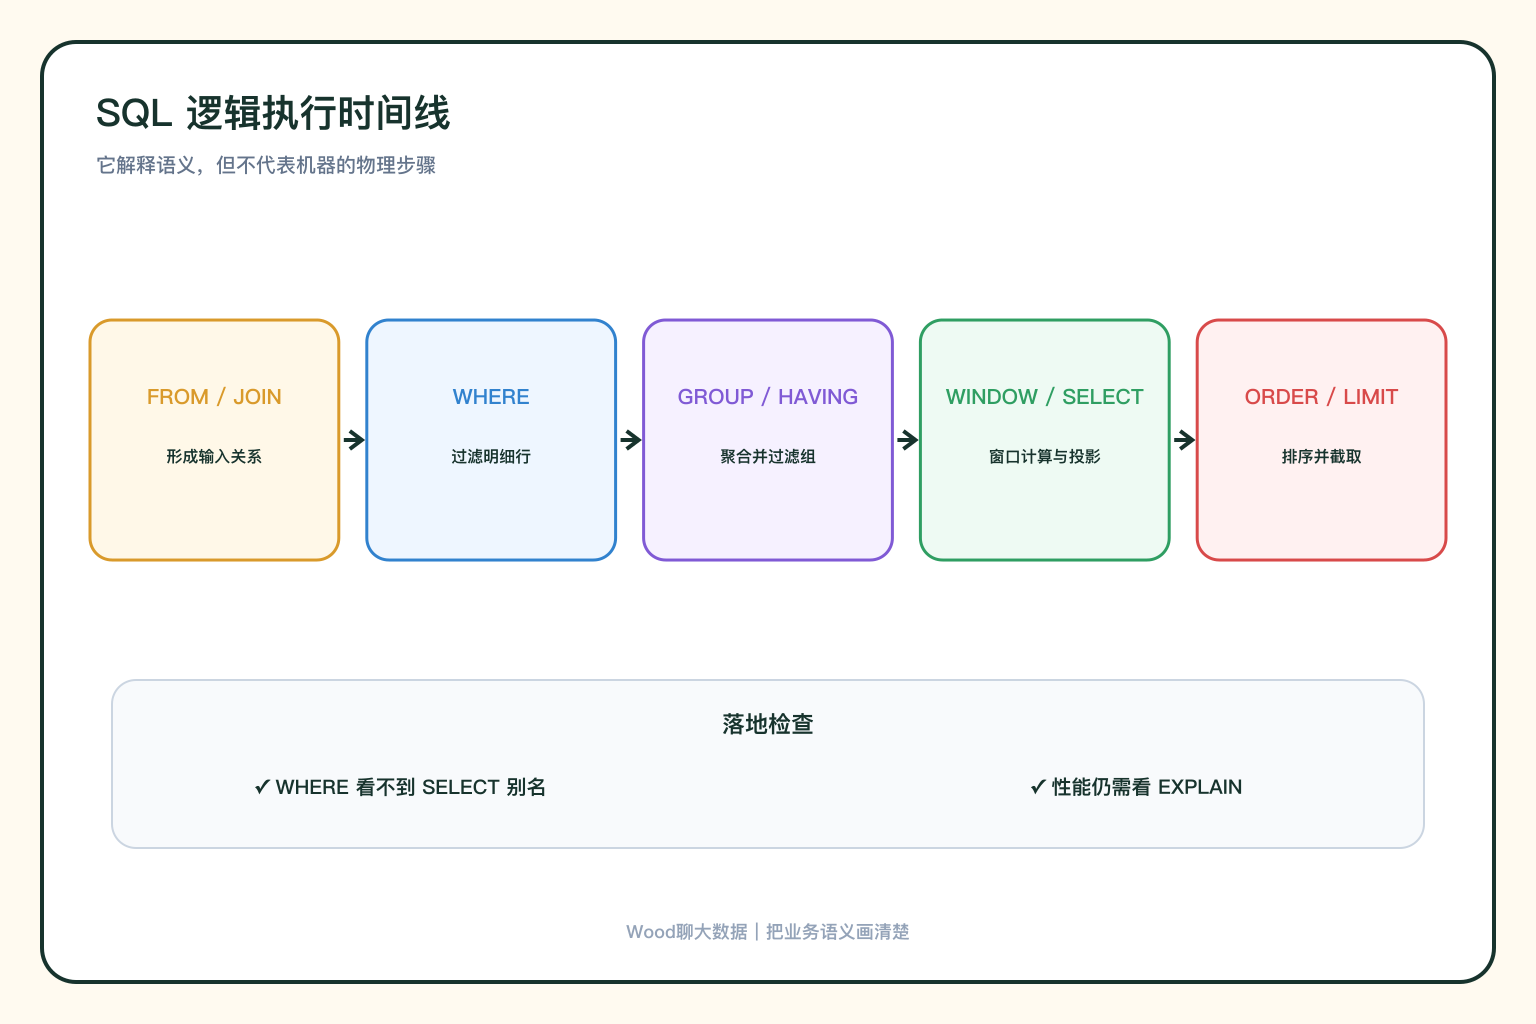
SQL 的书写顺序不等于逻辑执行顺序。可以简化理解为 FROM/JOIN、WHERE、GROUP BY 与聚合、HAVING、窗口函数、SELECT、DISTINCT、ORDER BY、LIMIT。它解释了 WHERE 为什么看不到 SELECT 别名、窗口结果为什么通常要外层过滤。还要区分逻辑顺序和物理计划:前者决定语义,后者可能被优化器重排,用于分析真实性能。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
答案不在书写顺序,而在逻辑执行顺序。
一条查询可以先按这个简化顺序理解:FROM/JOIN → WHERE → GROUP BY/聚合 → HAVING → 窗口函数 → SELECT → DISTINCT → ORDER BY → LIMIT/OFFSET。
不同数据库在语法细节上会有差异,但这条主线足以解释大多数 SQL 问题。
为什么 WHERE 看不到 SELECT 别名?
SELECT pay_amount * rate AS revenue
FROM orders
WHERE revenue > 100;
逻辑上 WHERE 发生在 SELECT 之前,此时 revenue 这个输出别名还没有形成。可以重复表达式,或先用子查询/CTE 生成别名:
WITH t AS (
  SELECT pay_amount * rate AS revenue
  FROM orders
)
SELECT *
FROM t
WHERE revenue > 100;
而 ORDER BY 在 SELECT 之后,所以大多数引擎允许按 SELECT 别名排序。GROUP BY、HAVING 是否接受别名存在引擎差异,跨引擎代码最好不要依赖特殊规则。
每一步到底产生什么?
FROM 和 JOIN 先决定输入数据集以及表之间如何组合;WHERE 删除不符合条件的明细行;GROUP BY 把行组织成组,聚合函数在组上计算;HAVING 再过滤聚合结果。
窗口函数通常在明细过滤和聚合之后计算,但不会像 GROUP BY 那样把结果压缩成一行一组。随后 SELECT 形成输出列,DISTINCT 对输出行去重,ORDER BY 排序,最后 LIMIT/OFFSET 截取结果。
这能解释哪些常见现象?
第一,WHERE 不能直接写 ROW_NUMBER() = 1。窗口结果尚未产生,需要套一层子查询,或使用支持 QUALIFY 的引擎语法。
第二,LEFT JOIN 后在 WHERE 过滤右表字段,可能删掉右侧没有匹配的行。因为 JOIN 先产生 NULL 扩展行,WHERE 再把它们过滤掉。
第三,LIMIT 不是“让前面所有步骤只处理几行”的保证。逻辑上它很靠后,实际能否提前停止取决于执行计划、排序和引擎实现。
第四,SELECT 中两个别名通常不能互相引用,因为它们处在同一逻辑层级,并没有可靠的先后关系。
逻辑顺序不等于物理执行计划
优化器可能下推过滤、重排 Join、做列裁剪或改写聚合,所以机器实际执行未必严格照着这条时间线一步一步走。
逻辑顺序用于判断 SQL 语义;物理计划用于分析扫描量、数据交换、Join 策略和性能。面试中如果把两者混为一谈,很容易说成“数据库一定先完整 Join,再执行 WHERE”,这并不准确。
怎么用它排查 SQL?
遇到别名不可见、窗口函数不能过滤、Join 后行数变化时,我会按逻辑阶段逐层写 CTE,并检查每层的粒度、行数和唯一键。确认语义后,再看 EXPLAIN 判断优化器实际如何执行。